
Raspagem de Dados com Pandas – read_html
Aprenda a fazer raspagem de dados com Pandas, ou web scraping, um método automatizado de extração de dados de sites.
Caso prefira esse conteúdo no formato de vídeo-aula, assista ao vídeo abaixo ou acesse o nosso canal do YouTube!
O que você aprende neste vídeo
Resposta rápida: A aula usa pd.read_html numa página da Wikipedia com sete tabelas, pega a primeira como DataFrame e segue em pandas puro. Depois explica como a função acha uma tabela no HTML, o que o robots.txt de Wikipedia, Globo, Record, IBGE e GitHub permite, e quando há caminho melhor que raspar.
Neste vídeo (42 min):
- 1:26 - A página da Wikipedia com as maiores empresas do Brasil, que tem várias tabelas
- 4:01 - Ler a página com
pd.read_html, passando a URL - 5:22 -
len(tabelas)conta sete tabelas na página - 7:37 - Tirar com
dropa coluna de numeração que repetia o índice do pandas - 9:23 - Limpar o “em bilhões de dólares” repetido nos nomes das colunas com
str.replace - 11:29 - A documentação do
read_htmle os parâmetros para quando a leitura falha - 14:08 - O código-fonte da página (
Ctrl + U) e a busca pelo marcador de tabela, que aparece sete vezes - 20:56 - No
robots.txt,User-agent: *comDisallow: /barra todo robô no site inteiro - 24:24 - O
robots.txtda Wikipedia avisa que o robô irresponsável é bloqueado - 30:23 - Globo e Record: o mapa do site e o bloqueio ao
GPTBot - 35:19 - A página do Censo 2022 do IBGE oferece download em CSV e XLSX
- 37:34 - O
robots.txtdo GitHub barra as páginas e indica a API
Trechos do vídeo:
- O
read_htmldevolve uma lista com todas as tabelas da página, inclusive o bloco de links que o HTML também marca como tabela. A que interessa se pega pela posição, que no Python começa em zero. - A função procura o elemento
<table>no HTML. Tabela publicada como imagem ela não lê, e dado que só lembra uma tabela, sem esse marcador, pode não ser encontrado. - No
robots.txt, o que não aparece como não permitido é, em princípio, permitido. E o arquivo é só uma instrução: o site pode bloquear o IP de quem não a respeita, por um tempo ou de vez. - Raspagem é o último recurso: primeiro veja se o site oferece o arquivo dos dados para baixar, depois se tem uma API, e só então raspe, conferindo as regras do
robots.txt.
Para receber por e-mail o(s) arquivo(s) utilizados na aula, preencha:
Raspagem de Dados com Pandas
Hoje vou falar sobre um assunto muito interessante e importante que é a raspagem de dados com Pandas, ou Web Scraping, um termo que você já deve ter visto por aí.
A raspagem de dados é uma técnica utilizada para obter dados da internet. Com ela, podemos obter diversas informações, como tabelas, que podem ser tratadas e utilizadas com o Pandas normalmente.
No entanto, apesar de ser uma técnica muito comum, a raspagem de dados não é permitida em todas as páginas da internet. Este é outro tópico importante que vamos abordar hoje: como verificar se uma página está apta ou não para a raspagem de dados.
Além disso, vou te mostrar como verificar outras formas de obter as informações relevantes que você precisa antes de optar pela raspagem de dados, como arquivos disponíveis para download ou a disponibilidade de uma API.
Não se esqueça de fazer o download do material disponível para acompanhar melhor o conteúdo desta aula.
Raspagem de Dados com Pandas – Pandas read_html
Quando estamos trabalhando com dados, é muito comum nos depararmos com dados tabulares, informações organizadas em formato de tabela, com linhas e colunas.
Esses dados podem ser extraídos, tratados e utilizados para diversas análises e construção de gráficos.
Por meio do Pandas, podemos otimizar e automatizar esse processo através da função read_html, que recebe como argumento o link da página desejada e retorna uma lista com todas as tabelas presentes nela.
Para identificar as tabelas dentro de uma página, a função read_html busca dentro do código HTML da página os elementos <table>, as linhas <tr> e <th>, e os elementos <td> dentro delas.
Cada um desses termos entre < > são elementos HTML que identificam e estruturam os componentes de uma página web. Esses elementos acima são especificamente responsáveis por construir uma tabela.
É importante ter esse conhecimento, mesmo que básico, sobre HTML, para que você possa compreender melhor o funcionamento dessa função e evitar problemas e erros ao tentar aplicá-la em diferentes contextos.
Por exemplo, se dentro de uma página na internet a tabela for uma figura, uma imagem, marcada pela tag <img>, a função read_html não funcionará.
Obs.: Dentro da documentação do Pandas, você pode encontrar mais informações detalhadas sobre o uso dessa função e os parâmetros disponíveis para ela.
Utilizando a Função read_html do Pandas
Para simular o uso dessa função e o processo de extração de dados tabulares, utilizaremos esta página da Wikipédia com a lista das maiores empresas do Brasil de acordo com a Forbes.
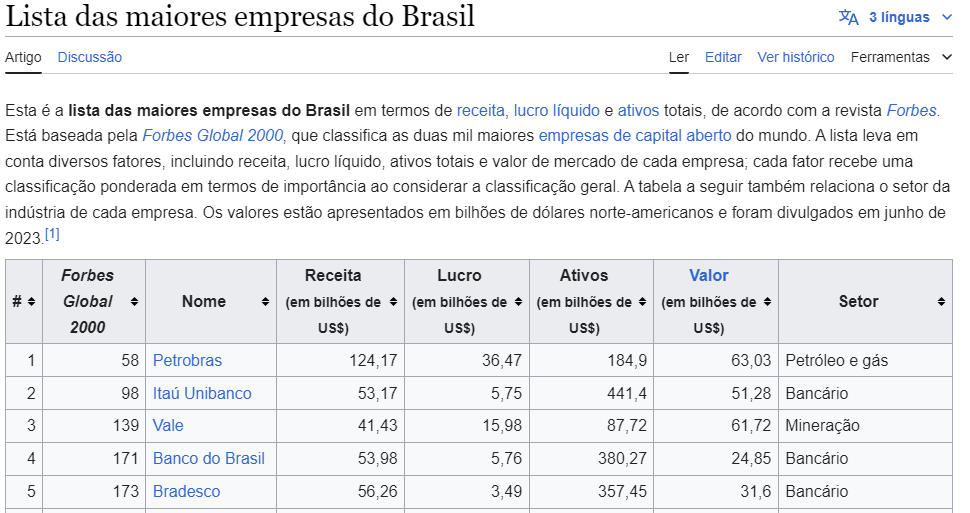
Basta importarmos o Pandas e utilizar a função read_html, passando o link para a página da Wikipédia.
import pandas as pd
URL = "https://pt.wikipedia.org/wiki/Lista_das_maiores_empresas_do_Brasil"
tabelas = pd.read_html(URL)
tabelas Ciência de Dados Impressionador
Se você quiser sair do zero até o nível avançado e aprender absolutamente tudo o que você precisa para usar Ciência de Dados para se destacar no Mercado de Trabalho e poder entrar nas carreiras mais promissoras e desejadas nas empresas, esse curso é pra você.
Começar agora


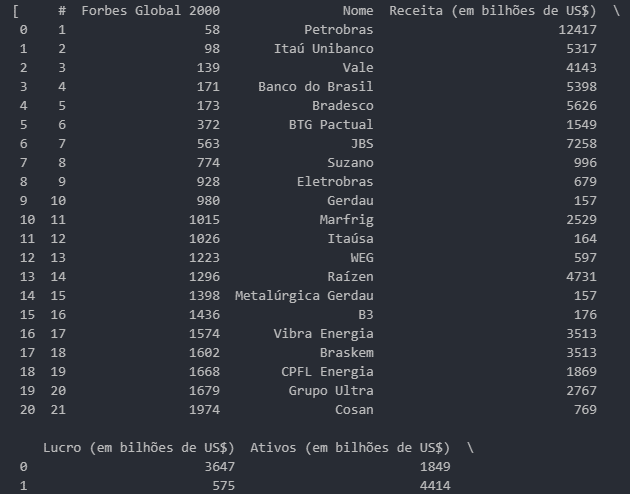
Dessa forma, podemos escolher a tabela de interesse com base na posição dela dentro dessa lista. Para o nosso exemplo, vamos considerar a tabela inicial de índice 0 (tabelas[0]).
Essa tabela já é um DataFrame do Pandas, mas podemos associá-la a uma variável para facilitar a manipulação e visualização.
df_forbes_2000 = tabelas[0]

df_forbes_2000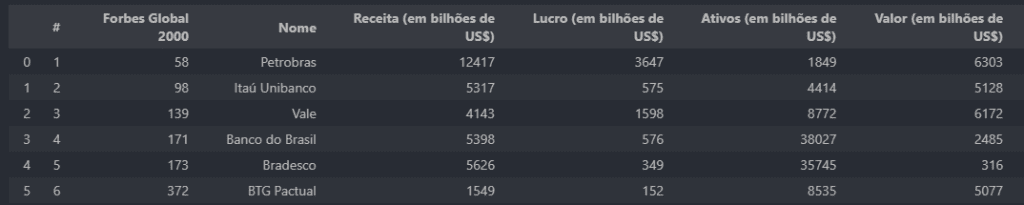
Tratando e Trabalhando com os Dados
A partir disso, podemos tratar e analisar esse DataFrame normalmente, como faríamos com qualquer outro utilizando o Pandas.
Por exemplo, podemos remover a coluna # para evitar a repetição com o índice numérico criado automaticamente pelo Pandas.
df_forbes_2000 = df_forbes_2000.drop(columns=["#"])

df_forbes_2000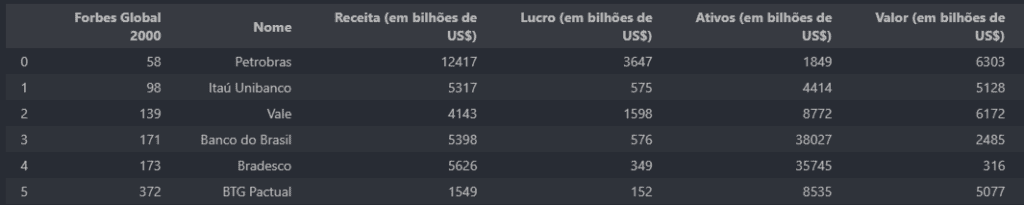
Podemos também ajustar o nome das colunas removendo o termo “(em bilhões de US$)” que aparece em todas elas, utilizando o método replace, que substituirá essa parte da string por um espaço vazio.
# remove (em bilhões de US$) dos nomes das colunas

df_forbes_2000.columns = df_forbes_2000.columns.str.replace(r" (em bilhões de US$)", "")

df_forbes_2000.columns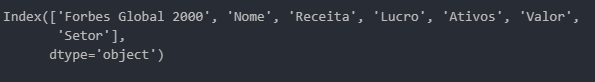
E assim, você pode tratar e manipular esse DataFrame para desenvolver as análises que quiser, de acordo com os seus interesses e objetivos.
Quando Podemos Fazer a Raspagem de Dados?
Agora que você já compreendeu o funcionamento e o uso da função read_html, é importante discutirmos sobre quando podemos ou não fazer a raspagem de dados em um site.
Ao navegar pela internet, você já deve ter se deparado com sites que trazem uma seção ou uma página com o nome de Políticas de Uso, ou Termos de Uso, entre outras variações de nomes semelhantes.
Dentro das políticas de uso dos sites, encontramos indicações sobre o que pode ou não ser feito com os dados oriundos daquela página.
Além disso, cada página web possui um arquivo chamado robots.txt que define as permissões de acesso automatizado às páginas do site.
Protocolo de Exclusão de Robôs – robots.txt
Os robôs, ou robots, são programas automatizados que percorrem as páginas da internet para coletar informações relevantes. Eles podem ser utilizados para indexar, verificar, monitorar e analisar os dados em uma determinada página.
Mecanismos de busca como Google, Bing e Yahoo utilizam esses robots para encontrar, analisar e classificar as páginas web que serão exibidas nos resultados de buscas de acordo com o tema pesquisado.
Para passar instruções a esses robôs sobre quais páginas ou seções do site eles podem ou não acessar, os administradores da página utilizam o arquivo robots.txt. Esse processo é chamado de Protocolo de Exclusão de Robôs.
Ao acessar um site, o robô deve buscar primeiro pelo arquivo robots.txt para identificar quais páginas ou seções estão com o acesso liberado ou restrito.
Por exemplo, se o conteúdo do arquivo listar algo como:
User-agent: *
    Disallow: /
O robô identificará que, a partir da página raiz do site, identificada pela barra /, seu acesso não é permitido.
O user-agent identifica os acessos dos robôs nas páginas. O asterisco indica que essa regra é válida para todos os robôs e automações envolvendo o site.
Alguns sites permitirão o acesso e a indexação de algumas páginas, porém impedirão o acesso a outras, como páginas administrativas ou com informações sensíveis.
Você pode conferir mais exemplos sobre aplicações e usos do robots.txt na página em inglês da Wikipédia ou na página do Google para desenvolvedores.
Para verificar o robots.txt de qualquer página, basta acessar a página raiz do site e adicionar ao final do endereço robots.txt.
Por exemplo, a página raiz do site da Wikipédia é:
Para acessarmos o arquivo robots.txt, devemos adicionar /robots.txt ao final desse endereço:
https://pt.wikipedia.org/robots.txt
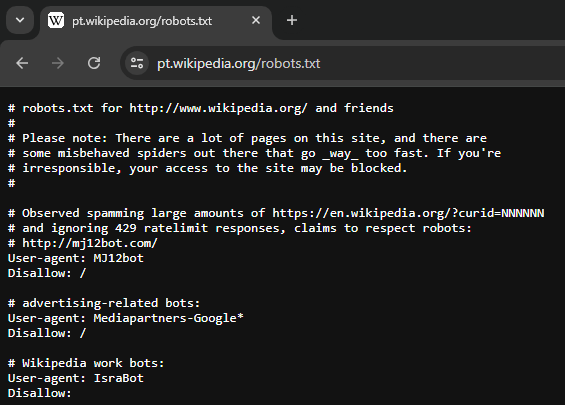
Comportamento dos Robôs na Internet
Outro ponto importante ao fazer a raspagem de dados de um determinado site é o comportamento da sua automação.
Os sites tendem a bloquear acessos rápidos e constantes com frequência para evitar sobrecarga nos servidores e quedas nos serviços.
Isso acontece porque manter um site no ar gera custos e os servidores são configurados para suportar uma determinada quantidade de acessos.
Se diversos robôs passarem a acessar o site constantemente e rapidamente para tentar buscar o maior número de informações, isso gerará uma sobrecarga nos serviços. Por isso, ao identificar esse tipo de comportamento, o servidor pode bloquear o seu acesso.
É por isso que é tão importante entender as políticas de uso e as formas educadas de realizar suas consultas e acesso aos dados online disponíveis para evitar problemas e bloqueios.
Outras Formas de Acesso aos Dados
Antes de partir para a raspagem de dados, é interessante verificar a existência de outras formas legítimas e amigáveis para acessar os dados em sites específicos.
Por exemplo, dentro do site do IBGE, podemos baixar os dados do censo de 2022 através de um menu de download, que nos permite escolher até mesmo o formato em que obteremos esses dados.

Essas alternativas são mais amigáveis e até mesmo mais eficientes na hora de automatizar o processo, pois é muito mais prático automatizar um robô para fazer o download desse arquivo do que fazer a raspagem dos dados.
Além das opções de download dos arquivos disponíveis diretamente na página, alguns sites também oferecem o acesso a APIs completas que nos permitem obter e utilizar os dados de forma automática e eficiente.
Como no caso do GitHub, que possui uma API própria para esse tipo de utilização.
Conclusão – Raspagem de Dados com Pandas
Nessa aula, eu te mostrei como fazer raspagem de dados com Pandas utilizando a função read_html e como fazer essa raspagem de forma amigável e legítima nos sites.
Você aprendeu como verificar se um site aceita o web scraping ou a automação de robôs dentro dele e quais os cuidados deve tomar para não ser bloqueado ou ter o seu acesso restringido dentro dele.
Além disso, apresentei outras formas eficientes e amigáveis de consumir os dados de uma página sem precisar fazer a raspagem de dados, como o uso de uma API própria fornecida pelo site.
Caso queira aprender outras formas de realizar raspagem de dados, temos mais posts aqui no blog sobre esse assunto. Vale a pena conferir e aprofundar seus conhecimentos:
Hashtag Treinamentos
Para acessar outras publicações de Ciência de Dados, clique aqui!
Posts mais recentes da Hashtag Treinamentos
- ChatGPT para criar fórmulas no Excel: 5 exemplos práticos
 Aprenda a usar o ChatGPT para criar fórmulas no Excel com 5 exemplos práticos de SOMA, SOMASES, SE, PROCV e CONT.SES, e veja como pedir certo e validar.
- Novidades do Claude: 11 funções do Claude 2.0 para usar já
 Conheça as novidades do Claude 2.0: sessões aninhadas, sessão mestre, side chat, dashboards, Motion, comandos e atalhos para trabalhar mais rápido.
- Cursor para iniciantes: tutorial completo passo a passo
 Cursor para iniciantes: aprenda a instalar, configurar o modelo, usar os modos Plan e Ask e criar sua primeira automação em Python com IA.
- Claude Artifacts: crie dashboards, slides e sites com IA
 Aprenda a usar o Claude Artifacts para criar dashboards, apresentações e sites com IA a partir de um prompt, com exemplos e prompts prontos para copiar.
- Tendências de tecnologia para empresas: o que muda em 2027
 Tendências de tecnologia para empresas: veja o que vem depois do ChatGPT em 2027, de agentes e IA de voz a software sob medida, e como preparar a equipe.
- Como usar o Excel para saber se uma mudança melhorou de verdade
 Aprenda a montar no Excel um gráfico de tendência com a mediana e a regra dos 6 pontos para saber se uma mudança melhorou de verdade ou se é ruído.


