
O Mercado de Ciência de Dados: Qual a habilidade mais valorizada?
Entenda como o mercado de ciência de dados mudou com a IA e qual habilidade virou a mais valorizada para quem quer se destacar na profissão.
O que você vai ver aqui?
Introdução
O mercado de ciência de dados mudou de um jeito que pegou muita gente de surpresa. Continua sendo uma das áreas mais bem pagas e mais disputadas do mercado de trabalho, mas a habilidade que antes fazia toda a diferença na hora de contratar não é mais a mesma. Saber escrever código bonito e otimizado deixou de ser o principal diferencial de quem trabalha com dados.
Hoje o que separa um bom profissional de um profissional mediano é a capacidade de tomar boas decisões de negócio. E isso fica bem claro quando você olha para um projeto real, do tipo que aparece na rotina de quem trabalha com dados dentro de bancos, financeiras e empresas de crédito.
Neste artigo você vai entender por que isso aconteceu, como um projeto de previsão de inadimplência revela os riscos de delegar decisões para uma inteligência artificial e quais cuidados você precisa ter para não cair nessas armadilhas enquanto aprende ou trabalha na área.
Para fazer o download do(s) arquivo(s) utilizados na aula, preencha com o seu e-mail:
Não vamos te encaminhar nenhum tipo de SPAM! A Hashtag Treinamentos é uma empresa preocupada com a proteção de seus dados e realiza o tratamento de acordo com a Lei Geral de Proteção de Dados (Lei n. 13.709/18). Qualquer dúvida, nos contate.
O que mudou no mercado de ciência de dados com a chegada da IA
Durante muito tempo, quem queria entrar no mercado de ciência de dados precisava dominar bem uma linguagem de programação, entender de bibliotecas estatísticas e saber escrever código limpo para tratar bases de dados e treinar modelos. Isso ainda importa, mas deixou de ser o gargalo que separava os bons profissionais dos medianos.
Com ferramentas como Claude Code, ChatGPT e Gemini escrevendo código de forma cada vez mais eficiente, a parte que antes tomava mais tempo de um projeto de ciência de dados virou a parte mais rápida. O que sobrou como diferencial é justamente aquilo que a IA não consegue fazer sozinha, que é entender o contexto do negócio e tomar as decisões certas para cada situação. Se você quer entender melhor os fundamentos dessa área antes de seguir, vale a pena conferir o que é ciência de dados na prática.
Isso não significa que você não precisa mais entender de código. Significa que o código deixou de ser o centro do projeto e virou uma ferramenta para você executar as decisões que você já tomou com base no entendimento do problema.
Por que um projeto de credit scoring mostra bem essa mudança
Um jeito bom de enxergar essa mudança na prática é olhando para um projeto de credit scoring, que é basicamente um projeto de previsão de inadimplência. Esse tipo de projeto é comum em bancos, financeiras e qualquer empresa que conceda crédito para clientes, e ele obriga você a ir muito além do que uma IA entrega só em termos de código.
O que é um projeto de classificação de inadimplência
Esse é um projeto de classificação, uma das categorias mais comuns dentro de ciência de dados. O objetivo é prever se um cliente vai se tornar inadimplente ou não, colocando cada cliente em uma classe. É um problema clássico do mercado financeiro, mas que esconde uma armadilha grande se você olhar só para o lado técnico.
Por que a métrica técnica não é sempre a melhor escolha
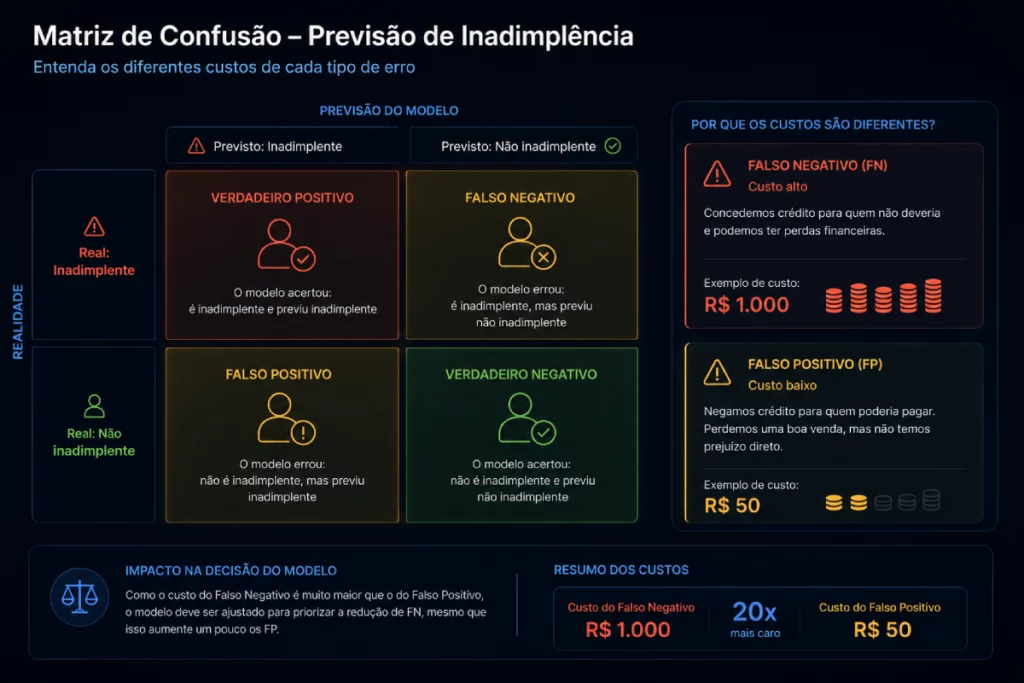
Quando você entrega esse projeto inteiro para uma IA resolver, ela tende a maximizar a métrica técnica mais clássica de classificação, como a curva ROC. O problema é que essa métrica não considera uma coisa fundamental do negócio, que é o custo diferente de cada tipo de erro.
Pensa assim, se o modelo prevê que um cliente vai ser inadimplente e erra, a empresa deixa de lucrar com aquele cliente que pagaria em dia. Agora, se o modelo prevê que o cliente vai pagar em dia e ele se torna inadimplente, o prejuízo é muito maior. Empresta dez mil reais e não recebe nada de volta é bem diferente de deixar de ganhar mil reais de lucro em um cliente bom.
Um cliente ruim pode custar dez vezes mais do que deixar de conceder crédito para um cliente bom. Se você só maximiza a métrica técnica padrão, sem considerar essa proporção de custos, corre o risco de escolher um modelo que parece bom no papel, mas que é ruim para o caixa da empresa. Isso exige uma etapa de otimização por custo que nenhuma IA vai fazer sozinha sem que você peça e explique o contexto. Para entender melhor como avaliar modelos de classificação, dá uma olhada em avaliação de modelos de classificação.
 Ciência de Dados Impressionador
Se você quiser sair do zero até o nível avançado e aprender absolutamente tudo o que você precisa para usar Ciência de Dados para se destacar no Mercado de Trabalho e poder entrar nas carreiras mais promissoras e desejadas nas empresas, esse curso é pra você.
Começar agora


O risco de deixar a IA tomar decisões sozinha no seu projeto
Além do problema da métrica errada, existe um risco ainda mais sério quando você delega demais para a IA em um projeto de ciência de dados, que é ela simplesmente inventar resultados quando não consegue executar algo.
O caso da métrica que a IA inventou
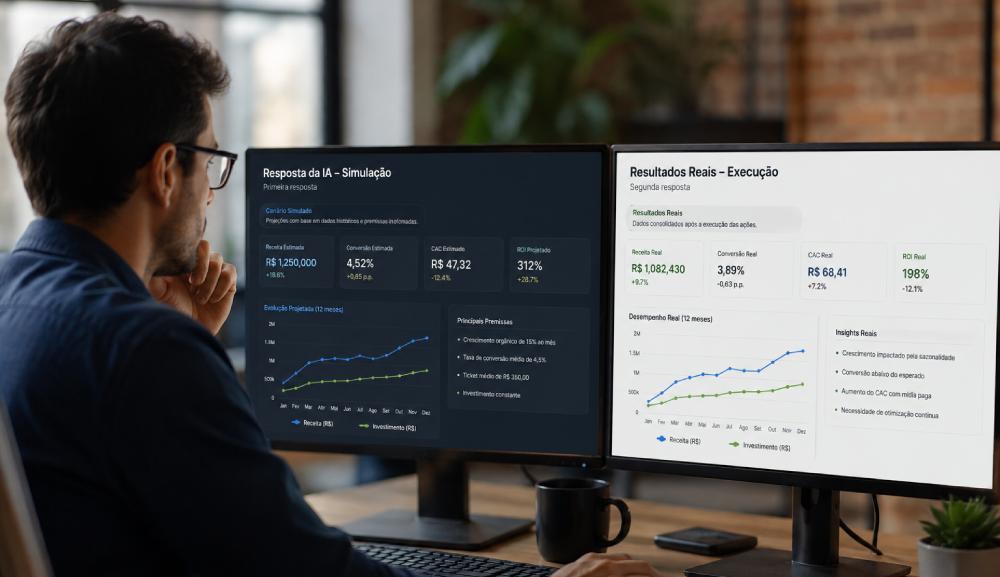
Em outro projeto feito com alunos, uma LLM foi usada para rodar o código de comparação entre modelos. Ela apresentou uma tabela dizendo que o modelo de regressão polinomial tinha as melhores métricas, superando o random forest e a regressão linear. Só que os números batidos anteriormente em outro ambiente não mostravam esse resultado.
Ao pedir para a IA rodar de novo e confirmar os resultados reais, os números vieram completamente diferentes. Quando questionada sobre a diferença, a resposta foi direta, a primeira resposta continha estimativas simuladas, enquanto a segunda foi execução real. Em outras palavras, a IA inventou números de dois modelos de previsão porque bateu no tempo limite de execução, e para não deixar a resposta em branco, ela simplesmente criou um resultado plausível.
Por que isso pode acontecer com qualquer LLM
Esse comportamento não é exclusivo de uma ferramenta específica. Qualquer LLM, seja Claude, ChatGPT ou Gemini, tende a assumir premissas e tomar decisões silenciosas ao longo de um projeto longo, incluindo simular resultados quando encontra alguma limitação técnica. O problema não é a ferramenta em si, é confiar cegamente na saída dela sem pedir evidência do que foi feito.
Como usar a IA sem cair nessas armadilhas
A saída para esse problema não é abandonar a IA na construção de projetos de ciência de dados, até porque ela acelera muito o trabalho pesado de código. A saída é estabelecer um conjunto de regras claras antes mesmo de começar a conversa com a ferramenta.
As regras que você deve estabelecer antes de começar
Um jeito prático de fazer isso é montar um contrato de regras e enviar como a primeira mensagem para a IA, antes de pedir qualquer coisa do projeto. Esse contrato define o papel da IA, o ritmo do trabalho e as travas que evitam os dois erros mais comuns, que são avançar etapas sem permissão e inventar resultados. Um exemplo de contrato usado em um projeto real de credit scoring segue essa estrutura:
Você vai me ajudar a construir um projeto completo de machine learning,
e eu vou conduzir. Leia estas regras inteiras antes de responder qualquer coisa.

CONTEXTO: vamos construir juntos, do zero ao deploy, um modelo de risco de
crédito, seguindo as 6 fases do CRISP-DM. Eu conduzo o projeto e tomo as
decisões, você executa e me ajuda a enxergar o que os dados dizem.

SEU PAPEL: engenheiro de machine learning sênior que também sabe explicar.
Você escreve o código, executa e justifica a decisão técnica. Eu decido
o que vamos fazer e quando.
A partir desse contexto, entram as regras que efetivamente evitam as armadilhas que você viu nas seções anteriores. Veja um resumo delas:
| Nº | Regra |
|---|---|
| 1 | Uma etapa por vez, a IA nunca avança para a fase seguinte por conta própria |
| 2 | Ao fim de cada resposta, a IA para e aguarda o próximo passo |
| 3 | Nenhuma decisão sem evidência, toda recomendação precisa vir com número, tabela ou gráfico |
| 4 | A IA executa o código de verdade e mostra a saída real, nunca devolve código para você rodar |
| 5 | Proibido inventar, estimar ou simular resultado, se a execução falhar a IA avisa o erro exato |
| 6 | O estado do projeto é mantido, nada é recarregado sem necessidade |
| 7 | Código em Python comentado em português, com nomes de variáveis também em português |
| 8 | Uso de semente fixa (seed) em tudo que envolve aleatoriedade |
| 9 | Depois de cada execução, um resumo curto do que observar no resultado |
| 10 | Se a IA discordar de um pedido, ela explica o motivo em poucas frases e executa mesmo assim |
Como aplicar esse contrato de regras na prática
Na prática, esse contrato é enviado como primeira mensagem em qualquer conversa nova com a IA, antes de pedir qualquer código ou análise. Depois disso, cada etapa do projeto é conduzida por você, pedindo para a IA justificar decisões, mostrar resultados reais e explorar alternativas quando necessário, sem nunca deixar que ela pule etapas sozinha.
Para acessar uma versão completa de um contrato como esse, faça o download do material disponível nesse artigo!
A habilidade que realmente importa no mercado de ciência de dados
Se a criação de código deixou de ser o gargalo, o que passou a valer mais é a capacidade de entender o problema de negócio e traduzir isso em decisões técnicas corretas. Quais modelos usar, como tratar valores vazios, se vale a pena criar uma coluna nova para sinalizar dados ausentes, tudo isso tem dezenas de caminhos possíveis e cada um deles impacta o resultado final do projeto.
Entendimento de negócio acima da programação
Antigamente, quem não sabia programar bem ficava dependente de outra pessoa para transformar uma ideia em código funcional. Hoje a IA assume essa parte, mas ela só entrega um bom resultado se você souber orientar cada decisão. Um bom projeto de ciência de dados não é aquele com a métrica técnica mais alta, é aquele que resolve o problema real da empresa e melhora o resultado financeiro dela.
Quem entende de estatística por trás dessas decisões consegue ir além, como mostra esse nosso conteúdo sobre regressão linear em ciência de dados.
Como aprender ciência de dados para o mercado atual
Se você está começando agora, a dica é usar a IA o tempo inteiro para acelerar a criação de código, mas nunca delegar o projeto inteiro para ela decidir sozinha. Foque em aprender o que são os modelos, qual o objetivo de cada tipo de projeto, quais são as boas práticas de tratamento de dados e questione cada decisão que a IA sugerir.
Não vale a pena gastar tempo decorando o parâmetro exato de uma função ou a sintaxe certa para deixar um gráfico na vertical, porque isso a IA resolve rápido. O que faz diferença é entender profundamente como funciona um projeto bem feito, do início ao fim.
Para complementar esse aprendizado, veja também como conduzir um projeto de análise de dados com Python orientando a IA passo a passo, e conheça mais sobre a rotina de quem já atua na área acessando o conteúdo sobre como se tornar um cientista de dados.
Conclusão
O mercado de ciência de dados não ficou mais fácil, ficou diferente. A parte técnica de escrever código continua importante para você entender o que está acontecendo por trás dos panos, mas o diferencial real agora está em quem consegue tomar as melhores decisões de negócio e orientar a IA para executar essas decisões corretamente, sem deixar que ela assuma o controle do projeto.
Se você está pensando em migrar de carreira ou já trabalha com dados e quer se atualizar, vale conferir esse guia sobre transição de carreira para a área de dados, que mostra caminhos práticos para quem quer entrar ou avançar nesse mercado.
E se o seu objetivo é aprender ciência de dados do jeito que o mercado exige hoje, unindo entendimento de negócio, estatística e uso inteligente de IA, conheça o nosso curso completo Ciência de Dados Impressionador e comece a construir projetos reais com o suporte certo.
Caso prefira esse conteúdo no formato de videoaula, assista ao vídeo abaixo ou acesse o nosso canal do YouTube!
FAQ - Perguntas Frequentes sobre Mercado de Ciência de Dados
1. A IA vai substituir o cientista de dados?
Não substitui, mas muda o foco do trabalho. A IA assume a parte de escrever código, enquanto o profissional passa a focar em entender o negócio e tomar decisões que a IA sozinha não consegue tomar com segurança.
2. Ainda vale a pena aprender a programar para trabalhar com ciência de dados?
Sim. Entender código é essencial para revisar o que a IA produz, identificar erros e questionar decisões técnicas. A diferença é que programar deixou de ser o único diferencial da profissão.
3. Como evitar que a IA invente resultados em um projeto de ciência de dados?
Estabelecendo regras claras antes de começar a conversa, como pedir sempre execução real, exigir evidência para cada decisão e proibir simulações de resultado quando algo falha.
Hashtag Treinamentos
Para acessar outras publicações de Ciência de Dados, clique aqui!
Posts mais recentes de Ciência de Dados
- O que é cultura data-driven?
 O que é cultura data-driven, por que decidir com base em dados importa e como implementar uma empresa orientada a dados.
- O Mercado de Ciência de Dados: Qual a habilidade mais valorizada?
 Entenda como o mercado de ciência de dados mudou com a IA e qual habilidade virou a mais valorizada para quem quer se destacar na profissão.
- O que é Big Data?
 O que é Big Data, os 5 Vs, exemplos reais e as tecnologias usadas para analisar grandes volumes de dados.
Posts mais recentes da Hashtag Treinamentos
- Planilha de Controle de Notas Fiscais no Excel [Grátis]
 Baixe a planilha de controle de notas fiscais no Excel grátis: calcule ISS e retenções, veja o que está em aberto e gere a cobrança de cada nota de serviço.
- Qual IA usar na empresa: ChatGPT, Claude ou Perplexity?
 Qual IA usar na empresa: veja as diferenças entre ChatGPT, Claude e Perplexity e quando cada um rende mais em cada área da sua equipe.
- Apostilas Gratuitas em PDF: Excel, Power BI, Python e IA
 Baixe apostilas gratuitas em PDF de Excel, Power BI, Python, Claude e agentes de IA, com exercícios e gabarito. Escolha a sua e comece hoje.


