Como Criar Projetos em Python e Ganhar R$1.000
Aprenda a criar projetos em Python para automatizar processos e ganhar dinheiro com isso no mercado de freelancers.
Resposta rápida: um projeto de Python que se vende como freela resolve um problema concreto de quem paga, e o exemplo desta aula é um raspador que extrai dados de um site e organiza o resultado. O Beautiful Soup dá conta quando a página vem pronta do servidor; quando o conteúdo aparece só depois do JavaScript rodar, o Selenium é o caminho.
O que você vai ver aqui?
Introdução
Fala, impressionador!
Você quer ganhar dinheiro com Python fazendo projetos de freela? Neste guia completo, você vai aprender exatamente como construir um projeto profissional de web scraping do zero e descobrir as estratégias para se destacar em plataformas de freelancer.
Vamos criar juntos um projeto real de extração de dados que pode render até R$ 1.000, mostrando todas as decisões técnicas, ferramentas necessárias e até os erros que você pode encontrar pelo caminho.
Para fazer o download do(s) arquivo(s) utilizados na aula, preencha com o seu e-mail:
Não vamos te encaminhar nenhum tipo de SPAM! A Hashtag Treinamentos é uma empresa preocupada com a proteção de seus dados e realiza o tratamento de acordo com a Lei Geral de Proteção de Dados (Lei n. 13.709/18). Qualquer dúvida, nos contate.
Entendendo o projeto
Vamos construir um script que extrai automaticamente informações de contato (telefones) de múltiplos sites. Este é um projeto real que você pode encontrar em plataformas como Freelancer, onde clientes pagam entre US$ 175 e US$ 240 (cerca de R$ 900 a R$ 1.200).
Neste projeto, o cliente precisa de um script independente que funciona da seguinte forma:
- Lê uma lista de URLs de sites a partir de um arquivo de texto;
- Acessa cada site e extrai as informações de contato (telefones);
- Usa Inteligência Artificial para encontrar os telefones mesmo que estejam em formatos diferentes;
- Salva os resultados em um arquivo CSV organizado;
- Funciona no Windows 11.
Entendendo o Desafio do Scraping
Para realizar a busca da informação requisitada, usaremos o processo de web scraping que ajuda a extrair dados de sites de forma automatizada. Porém, existem alguns obstáculos:
- Sites dinâmicos vs estáticos: Sites estáticos carregam todo o conteúdo de uma vez. Sites dinâmicos (como YouTube) carregam conteúdo conforme você rola a página;
- Variação de estrutura: Cada site organiza suas informações de forma diferente no código HTML;
- Bloqueios de scraping: Alguns sites detectam e bloqueiam tentativas de scraping automatizado.
- Informações escondidas: Telefones podem estar dentro de links, botões ou seções específicas do site.
Para nosso projeto, vamos testar com sites reais de instituições de ensino:
- Hashtag Treinamentos
- Finat
- FGV
- IBMEC
- PUC-Rio
Esses sites têm estruturas variadas, o que nos ajuda a criar uma solução robusta.
Ferramentas de Scraping: Beautiful Soup vs Selenium
Há duas ferramentas muito utilizadas para realizar web scraping em Python: Beautiful Soup e Selenium. Cada uma delas possui características próprias, vantagens e limitações, e por isso a escolha da ferramenta ideal depende muito do tipo de site que será analisado.
O Beautiful Soup é uma biblioteca focada na extração de dados a partir do HTML de páginas estáticas. Ela se destaca por ser extremamente rápida e leve, consumindo poucos recursos da máquina. Além disso, é simples de utilizar e oferece uma curva de aprendizado tranquila, o que a torna ideal para cenários onde o conteúdo da página já está completamente presente no HTML.
No entanto, suas limitações aparecem quando lidamos com sites dinâmicos. Ela não é capaz de executar JavaScript e, por isso, não consegue capturar elementos carregados apenas após a interação com a página ou por requisições assíncronas.
Caso queira conhecer o Beautiful Soup, você pode acessar a aula Introdução ao Beautiful Soup.
Por outro lado, o Selenium funciona como um navegador automatizado. Ele abre páginas da mesma forma que um usuário real faria e por isso consegue lidar muito bem com sites dinâmicos. Com o Selenium é possível executar JavaScript, aguardar carregamentos, clicar em botões, preencher campos e interagir com praticamente qualquer elemento da página.
Em compensação, por simular um navegador completo, ele é mais lento que o Beautiful Soup, consome mais recursos e ainda exige a instalação de um driver específico para o navegador escolhido (como ChromeDriver ou GeckoDriver).
Caso queira conhecer o Selenium, você pode acessar a aula Selenium - Automatize Qualquer Tarefa na Internet com Python.
Diante disso, vamos iniciar o desenvolvimento utilizando Beautiful Soup, aproveitando sua velocidade e simplicidade. Caso o site analisado dependa fortemente de conteúdo dinâmico ou carregado via JavaScript, então partimos para o uso do Selenium, garantindo total controle sobre a interação com a página.
Configurando o Ambiente de Desenvolvimento
O primeiro passo é criar a estrutura para o projeto:
- Na área de trabalho crie uma pasta para o projeto chamado "FreelaScrape", por exemplo;
- Abra essa pasta no seu editor de código. Neste caso usaremos o VS Code e ao abrir a ferramenta, basta usar o atalho CTRL + O e selecionar a pasta desejada;
- Dentro da pasta crie os seguintes arquivos:
- main.py - Nosso código principal
- sites.txt - Lista de sites para extrair
No arquivo "sites.txt", adicione os sites de cada uma das instituições de ensino que utilizaremos como exemplo para testar o código linha a linha:
https://www.hashtagtreinamentos.com

https://fnat.com.br

https://portal.fgv.br

https://www.ibmec.br

https://www.puc-rio.br
Usando IA para Acelerar o Desenvolvimento
Uma opção para acelerar o desenvolvimento do código é usar inteligência artificial. Você pode usar o Chat GPT ou o Gemini para criar a estrutura inicial do código. Utilizaremos o seguinte prompt no Gemini para criar o código base que implementaremos nos próximos passos:
Preciso de um script independente que extrai telefones de sites usando OpenAI.

Como vai funcionar:
1. Vou inserir o endereço dos sites no arquivo sites.txt
2. Seu script encontrará o telefone em cada site e o extrairá
3. Você deve usar IA e Python para resolver isso
4. O script deve funcionar no Windows 11
5. Os sites não são padronizados - os telefones podem estar em qualquer lugar da página

Use para scraping o Beautiful Soup.
Caso use IA para criar o código inicial, é fundamental entender cada linha de código, para conseguir direcionar a inteligência artificial na resolução de problemas.
Instalando as dependências
A resposta da IA traz o código completo organizado em arquivos, dois deles já foram criados inicialmente, que são: "main.py" e o "sites.txt". O novo arquivo que ainda precisamos criar é o "requirements.txt", responsável por armazenar todas as dependências do projeto. Ele terá os seguinte conteúdo:
openAI
beautifulsoup4
requests
Após criar esse arquivo, podemos usar o atalho CTRL + J para abrir o terminal e instalá-las com o comando:
pip install -r requirements.txtO código acima , vai olhar dentro do arquivo "requirements.txt" todas as dependências que estão em cada linha e vai instalar todas de uma vez com o -r.
Caso precise de ajuda para configurar o Python no VS Code, você pode acessar o vídeo Como Configurar VSCode para Python.
 Python Impressionador
Você vai aprender a linguagem de Programação que mais cresce no Mundo para fazer automações incríveis, desenvolver sites, fazer análises de dados, trabalhar com Ciência de Dados, Inteligência Artificial, mesmo que você nunca tenha tido nenhum contato com Programação na vida.
Começar agoraQuero a oferta de Black Friday


Construindo o Script de Extração
O próximo passo é pegar o código que a IA forneceu, entender cada passo e alterar o que for necessário. O resultado será mostrado abaixo:
Começaremos com as importações das bibliotecas. no arquivo "main.py", insira o seguinte código:
#Importação das bibliotecas

import os
import requests
from bs4 import BeautifulSoup
from openai import OpenAI
O próximo passo é definir as variáveis globais:
# Insira a chave de API da OpenAI abaixo
API_KEY = "SUA_CHAVE_API_AQUI"

# Arquivo de entrada com a lista de sites que serão consultados
INPUT_FILE = "sites.txt"

# Arquivo de saída com os resultados
OUTPUT_FILE = "resultado_telefones.csv"

# Modelo da OpenAI (gpt-4o-mini é mais barato e rápido para essa tarefa)
MODELO = "gpt-4o-mini"
É muito importante lembrar que você nunca deve compartilhar sua chave da API da OpenAI publicamente. Para entregar o projeto ao cliente, substitua por um placeholder como "SUA_CHAVE_API_AQUI" como fizemos no código acima.
Na sequência, vamos inicializar a chave da openAi com o código:
client = OpenAI(api_key=API_KEY)Em seguida, a IA fornece três principais funções: limpar_html, extrair_telefone_com_ia e processar_sites. Cada uma responsável por uma funcionalidade específica na automação que está descrita na tabela abaixo:
| Função | O que faz | Por quê |
| limpar_html | Remove tags inúteis e deixa só o conteúdo visível | Para economizar tokens e melhorar a precisão da IA |
| extrair_telefone_com_ia | Usa a OpenAI para localizar o telefone principal | IA consegue identificar padrões complexos |
| processar_sites | executar todo o fluxo da automação. | É o "motor" da automação |
A estrutura que a IA apresenta inicialmente é uma excelente opção para seguirmos. Contudo, ela insere várias linhas de código que podemos deletar, pois não contribuem para a automação e funcionalidade de cada função.
Por isso, é extremamente importante revisar o código fornecido pela IA para conseguir criar um código otimizado e de qualidade.
Após tratar cada uma das funções, obtemos o seguinte código para cada uma:
- Função limpar_html
def limpar_html(html_content):
    """
    Limpa o HTML removendo elementos desnecessários.
    """

    # Converte o HTML em um objeto BeautifulSoup
    soup = BeautifulSoup(html_content, 'html.parser')

    # Só aplica limpeza pesada se o texto for grande
    if len(soup.text) > 2000:
        # Remove tags que não têm texto útil
        for element in soup(["script", "style", "meta", "noscript", "header", "svg", "path"]):
            element.extract()

    # Retorna o HTML limpo
return soup- Função extrair_telefone_com_ia
def extrair_telefone_com_ia(texto_site, url):
    """
    Envia o conteúdo do site para a IA e retorna o telefone encontrado.
    """

    # Define as instruções que orientam a IA sobre como extrair o telefone
    prompt_sistema = (
        "Você é um assistente especialista em extração de dados. "
        "Sua tarefa é encontrar o número de telefone principal no HTML fornecido. "
        "Prefira celulares ou fixos locais e também verifique números dentro de links. "
        "Retorne apenas o número formatado ou 'Não encontrado'."
    )

    # Monta o texto enviado para a IA com a URL e o conteúdo do site
    prompt_usuario = f"URL do site: {url}\n\nConteúdo do site:\n{texto_site}\n\nExtraia o telefone:"

    try:
        # Faz a requisição para a OpenAI usando o modelo configurado
        response = client.chat.completions.create(
            model=MODELO,
            messages=[
                {"role": "system", "content": prompt_sistema},
                {"role": "user", "content": prompt_usuario}
            ],
        )

        # Retorna o texto da resposta da IA, sem espaços extras
        return response.choices[0].message.content.strip()

    except Exception as e:
        # Retorna o erro caso a chamada à IA falhe
return f"Erro na IA: {e}"- Função processar_sites
def processar_sites():
    # Verifica se o arquivo de entrada existe
    if not os.path.exists(INPUT_FILE):
        print(f"Erro: Arquivo '{INPUT_FILE}' não encontrado.")
        return

    # Lê a lista de sites do arquivo
    with open(INPUT_FILE, 'r', encoding='utf-8') as file:
        sites = [line.strip() for line in file.readlines() if line.strip()]

    print(f"Iniciando extração de {len(sites)} sites...")

    # Cria o arquivo de saída com o cabeçalho
    with open(OUTPUT_FILE, 'w', encoding='utf-8') as file_out:
        file_out.write("URL;Telefone Extraido\n")

    # Define um User-Agent para evitar bloqueios ao acessar os sites
    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/91.0.4472.124 Safari/537.36'
    }

    for site in sites:
        # Garante que a URL tem http/https
        url_alvo = site if site.startswith('http') else f'https://{site}'
        print(f"Processando: {url_alvo}...", end="\r")

        try:
            # 1. Baixa o HTML do site
            response = requests.get(url_alvo, headers=headers, timeout=15)
            response.raise_for_status()

            # 2. Limpa o HTML removendo tags inúteis
            texto_limpo = limpar_html(response.content)

            # 3. Extrai o telefone usando IA
            telefone = extrair_telefone_com_ia(texto_limpo, url_alvo)
            print(f"[OK] {url_alvo} -> {telefone}")

            # 4. Salva o resultado no arquivo CSV
            with open(OUTPUT_FILE, 'a', encoding='utf-8') as file_out:
                file_out.write(f"{url_alvo};{telefone}\n")

        # Caso haja erro ao acessar o site
        except requests.exceptions.RequestException as e:
            print(f"[ERRO DE CONEXÃO] {url_alvo}: {e}")
            with open(OUTPUT_FILE, 'a', encoding='utf-8') as file_out:
                file_out.write(f"{url_alvo};Erro de acesso ao site\n")

        # Qualquer outro erro inesperado
        except Exception as e:
            print(f"[ERRO GERAL] {url_alvo}: {e}")
            with open(OUTPUT_FILE, 'a', encoding='utf-8') as file_out:
                file_out.write(f"{url_alvo};Erro desconhecido\n")
Ao final do arquivo temos o comando responsável por executar o processamento quando o script é iniciado:
if __name__ == "__main__":
    processar_sites()
Integrando a API da OpenAI
Já temos o código, agora precisamos da chave de API da OpenAI para conseguir integrá-la à automação que estamos construindo. Para ter acesso à essa chave, você precisa;
- Acessar o site da plataforma da OpenAI;
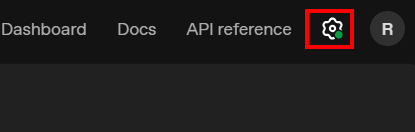
- Clique no ícone de engrenagem no canto superior direito da tela ao lado do avatar de perfi;
- No menu lateral clique na opção API Key;
- Clique no botão Create new secret Key;
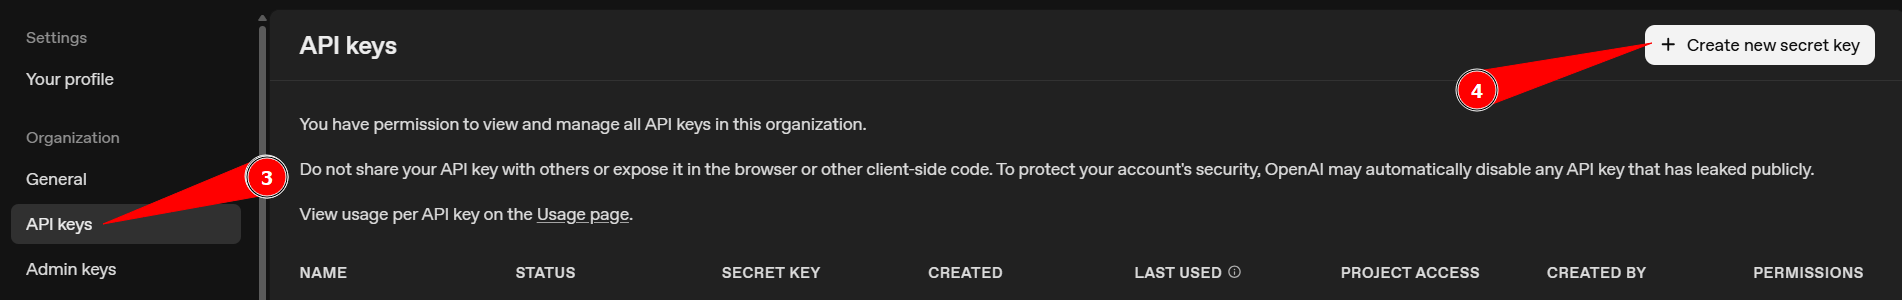
- Preencha o campo Name com o nome da chave de API;
- Selecione no campo Project um projeto para associar à essa chave de API;
- Clique no botão Create Secret Key;

- Clique no botão Copy para copiar a chave de API;

Resultado ao executar o código
Ao executar o código é possível trazer a maior parte dos números de telefone dos sites inseridos no arquivo "sites.txt".

Alguns sites como o da FGV, por exemplo, podem reconhecer um scraping e impedir a conexão, o que leva ao erro apresentado na imagem acima.
Outras opções como usar RPAs para simular o comportamento de um navegador real podem contornar essas restrições, pois esse tipo de ferramenta consegue respeitar políticas de cookies e replicar interações humanas, evitando bloqueios mais rígidos aplicados contra requisições automatizadas.
Conclusão
Construir projetos de Python para freela é uma excelente forma de ganhar dinheiro enquanto desenvolve suas habilidades. O segredo está em:
- Escolher projetos adequados ao seu nível;
- Usar IA para acelerar o desenvolvimento, mas entender o código;
- Entregar valor além do esperado (projeto pronto antes da contratação);
- Comunicar profissionalmente;
- Iterar e melhorar com cada projeto.
Este projeto de web scraping com OpenAI é apenas um exemplo. Você pode aplicar o mesmo processo para:
- Automação de planilhas;
- Bots de Telegram/Discord;
- Análise de dados;
- Integração de APIs;
- Scripts de produtividade.
Lembre-se: o conhecimento técnico é importante, mas a capacidade de entregar soluções completas e se comunicar bem são diferenciais ainda maiores no mercado de freelas.
Se você quer aprender mais sobre Python de forma prática e focada no mercado atual, conheça nosso Curso Python Impressionador.
Além disso, se preferir esse conteúdo no formato de vídeo-aula, assista ao vídeo abaixo ou acesse o nosso canal do YouTube!
O que você aprende neste vídeo
Resposta rápida: A aula pega um pedido real do freelancer.com, de extrair o contato de cada site listado num arquivo de texto usando a API da OpenAI, e constrói o script buscando o telefone, a partir de uma primeira versão gerada pelo Gemini com Beautiful Soup. Testa em cinco sites e ajusta o código até só a FGV ficar sem telefone.
Neste vídeo (51 min):
- 0:09 - O pedido de freela encontrado no freelancer.com
- 4:22 - Dica para o freela: mandar um vídeo do script já rodando junto com a proposta
- 7:26 - O pedido vai para o Gemini, com o Beautiful Soup como pré-requisito
- 10:58 - Instalação das bibliotecas com
pip install -r requirements.txt - 11:55 - O modelo GPT-4o mini, mais barato, para começar
- 12:23 - As três funções do código: limpar o HTML, extrair o telefone com IA e processar os sites
- 23:34 - Nome de variável de uma letra só, como o
fde file, não é intuitivo - 33:14 - Primeira execução: acha o telefone da FNAT e da PUC, e dá erro de conexão na FGV
- 37:56 - Mandar o HTML inteiro, e não só o texto, faz achar o telefone da Hashtag, que só aparece no link do WhatsApp
- 40:02 - Prompt ajustado para procurar o telefone no
hrefdas tagsa - 45:03 - Sem a limpeza de tags, o IBMC sai, mas a Hashtag passa do limite de tokens
- 47:33 - Limpeza só quando o texto passa de 2.000 caracteres
- 48:05 - Rodada final: só a FGV fica sem telefone
Trechos do vídeo:
- O Beautiful Soup não faz a requisição ao site: quem busca o HTML é o
requests, e o Beautiful Soup lê e trata esse código para o Python entender. - Temperatura perto de zero deixa o modelo mais preciso, mas ele pode deixar passar uma informação que existe; mais alta, a busca fica mais ampla e ele pode pegar informação errada. A aula começa sem passar o parâmetro e só ajusta se precisar.
- O projeto entregue ao cliente não leva a sua chave de API, e sim um espaço para a chave dele; senão você paga as requisições toda vez que ele usar o sistema.
- Para testar outras partes do código sem gastar requisição na API, um
returnno começo da função que chama a IA faz ela devolver vazio. - Há sites que bloqueiam a raspagem com qualquer ferramenta, Selenium ou Beautiful Soup; contornar exige um RPA, que precisa do computador ligado ou de uma máquina virtual.
Hashtag Treinamentos
Para acessar outras publicações de Python, clique aqui!
Posts mais recentes de Python
- Cursor para iniciantes: tutorial completo passo a passo
 Cursor para iniciantes: aprenda a instalar, configurar o modelo, usar os modos Plan e Ask e criar sua primeira automação em Python com IA.
- Agente de IA local com Python: crie o seu com Ollama
 Aprenda a criar um agente de IA local com Python, Ollama e LangChain: rode modelos no seu PC, sem pagar por API e sem expor os dados da empresa.
- Como Criar CRM com Codex no VS Code usando Python e Flask
 Aprenda a criar CRM com Codex no VS Code usando Python, Flask e SQLite, com login, orçamentos e PDF, em fases com testes e commits no Git.


Posts mais recentes da Hashtag Treinamentos
- ChatGPT para criar fórmulas no Excel: 5 exemplos práticos
 Aprenda a usar o ChatGPT para criar fórmulas no Excel com 5 exemplos práticos de SOMA, SOMASES, SE, PROCV e CONT.SES, e veja como pedir certo e validar.
- Cursor para iniciantes: tutorial completo passo a passoCursor para iniciantes: aprenda a instalar, configurar o modelo, usar os modos Plan e Ask e criar sua primeira automação em Python com IA.
- Claude Artifacts: crie dashboards, slides e sites com IA
 Aprenda a usar o Claude Artifacts para criar dashboards, apresentações e sites com IA a partir de um prompt, com exemplos e prompts prontos para copiar.