Introdução ao BeautifulSoup – Raspagem de Dados com Python
Você já sabe como usar o BeautifulSoup? Nesta aula vamos fazer a introdução ao BeautifulSoup, você vai aprender a usar essa ferramenta!
Caso prefira esse conteúdo no formato de vídeo-aula, assista ao vídeo abaixo ou acesse o nosso canal do YouTube!
O que você aprende neste vídeo
Resposta rápida: A aula apresenta o BeautifulSoup, biblioteca de raspagem de dados do Python, extraindo a cotação do dólar da busca do Google. Você aprende a baixar o HTML com requests, localizar elementos com find, find_all e class_, enviar um User-Agent de navegador e ler atributo ou texto. Ele atende sites estáticos; página dinâmica ou com login pede Selenium.
Neste vídeo (32 min):
- 2:02 -
pip install beautifulsoup4epip install requests, depoisimport requestsefrom bs4 import BeautifulSoup - 5:15 -
requests.get(link)baixa a página de busca: o código 200 confirma a requisição erequisicao.texttraz o HTML inteiro - 8:02 -
BeautifulSoup(requisicao.text, "html.parser")eprettify()para ver o HTML organizado emheadebody - 10:10 -
site.titleesite.find("title")devolvem o título da página pelo nome da tag - 12:05 - Inspecionar com a setinha do DevTools para descobrir a tag do campo de busca, um
input, e testarsite.find("input") - 14:40 -
findpara no primeiro elemento,find_alldevolve a lista de todos osinput, e o campo da busca sai pelo índice[1] - 19:05 - O limite da ferramenta: rápida em site estático, mas não acompanha conteúdo que carrega na rolagem, como no YouTube, nem clica, preenche formulário ou faz login
- 22:05 - O filtro
name="q"dá erro, e a busca passa para a classe copiada do inspecionar, escrita comoclass_ - 23:30 - O
findpela classe retornaNoneporque o Google reconhece a requisição do Python e entrega outra versão da página - 25:35 -
User-Agentcopiado de Request Headers, na aba Network, e passado como dicionário emheadersna requisição - 29:20 - A cotação fica num
spancom duas classes:site.findcom a tag e uma das classes para não pegar outro elemento - 30:25 - O atributo
["data-value"]traz a cotação com todas as casas decimais, eget_text()traz o texto arredondado, 5,24
Trechos do vídeo:
- O BeautifulSoup não acessa a internet sozinho: a biblioteca
requestsbaixa o HTML da página, e o BeautifulSoup transforma esse texto numa estrutura em que dá para buscar tags e atributos finddevolve o primeiro elemento que corresponde à busca efind_alldevolve uma lista com todos; depender da posição nessa lista quebra o código quando o site muda- No BeautifulSoup o filtro por classe se escreve
class_, com underline, porqueclassé palavra reservada do Python - Sem um
User-Agentde navegador nosheaders, o Google identifica a requisição feita pelo Python e devolve outra versão da página, em que elementos mudam de posição ou nem aparecem - O BeautifulSoup raspa sites estáticos com rapidez, mas não rola a página, não clica e não faz login; conteúdo carregado de forma dinâmica pede uma ferramenta que simule o navegador, como o Selenium
Para receber por e-mail o(s) arquivo(s) utilizados na aula, preencha:
Fala Impressionadores! Na aula de hoje eu quero te mostrar como fazer uma raspagem de dados com Python (Web scraping com Python).
Para isso nós vamos fazer uma breve introdução ao BeautifulSoup, que nada mais é do que uma ferramenta de raspagem de dados (obtenção de dados na web).
Eu vou te mostrar como extrair informações da web utilizando essa ferramenta para facilitar suas automações na busca de dados.
Você vai aprender o que é o BeautifulSoup, como ele funciona, como vamos buscar os dados na web com ele, como organizar o código do site e como trazer uma informação específica!
O BeautifulSoup é a biblioteca Python usada para raspagem de dados: ela organiza o HTML que a requests baixa e permite localizar informações com find e find_all. Instale com pip install beautifulsoup4, importe com from bs4 import BeautifulSoup e busque pela tag ou pela classe do elemento desejado.
 Python Impressionador
Você vai aprender a linguagem de Programação que mais cresce no Mundo para fazer automações incríveis, desenvolver sites, fazer análises de dados, trabalhar com Ciência de Dados, Inteligência Artificial, mesmo que você nunca tenha tido nenhum contato com Programação na vida.
Começar agora


Introdução ao BeautifulSoup
O primeiro passo é baixar o material da aula para acompanhar melhor a execução do código.
Um segundo ponto é que sempre que você for usar o BeautifulSoup você deve importar a biblioteca Requests, essas duas ferramentas devem ser usadas em conjunto porque é a biblioteca Requests que vai possibilitar fazer a raspagem dos dados.
No terminal vamos fazer as instalações:
>pip install beautifulsoup4

>pip install requests
Agora vamos importar:
Import requests

From bs4 import BeautifulSoup (para importar o BeautifulSoup é necessário colocar no início o From bs4)
Nosso exemplo é do site que faz a Cotação do Dólar em Tempo Real:
O exemplo que vamos usar nesta aula é muito simples, basicamente vamos entrar no site e pegar a cotação do dólar em tempo real.
Existem formas mais fáceis de coletar esta informação, mas, nesta aula nosso objetivo é mostrar o funcionamento do BeautifulSoup.
Vamos precisar trazer todo o código do site para dentro do Python, para isso vamos criar uma variável que vai receber o link do site que vamos utilizar.
Link do site:
Observe o link do site quando fazemos uma pesquisa, é este código gigante acima, podemos encurtar isso, basta que você copie todas as informações até o primeiro & que aparecer, desta forma você encurta o link sem comprometer a busca.
Resultado:
https://www.google.com/search?q=cota%C3%A7%C3%A3o+dolar
Código:
import requests

from bs4 import BeautifulSoup

link = “https://www.google.com/search?q=cotacao+dolar”

requisicao = requests.get(link)

print(requisicao)

print(requisicao.text)
Observe que no código estamos primeiro colocando o link do site dentro da variável link, após, estamos utilizando o Requests para fazer a importação do link e logo em seguida vamos printar as informações da variável Requisição e o texto da requisição.
Se a importação da requisição foi feita de forma correta então você vai encontrar depois de printar uma linha escrito <Response [200]>
O print do texto da requisição, por outro lado, vai gerar um código em HTML (parte azul da imagem).

Da forma como este código HTML vem, nós não conseguimos trabalhar, porque está desorganizado, para ajustar isso vamos usar o BeautifulSoup:
site = BeautifulSoup(requisicao.text, "html.parser")

print(site.prettify())
Se printarmos agora o resultado fica muito maior, porque vai estar na estrutura padrão do HTML, muito mais fácil de entender:
Início do Processo de Raspagem de Dados
Para buscar o título do site vamos buscar por:
titulo = site.find(“title”)

Print(titulo)
O título que vem como resultado é o mesmo título da aba de pesquisa do site, mas, como saber qual é a tag HTML que você deve usar para acessar algo que está no site? Neste caso usamos o “title” e quando procurarmos outra informação que não seja o título?

Para isso, temos algumas pesquisas a fazer, você deve entrar no site e clicar com o botão direito do mouse -> clique em inspecionar.

Clique na seta indicada na imagem acima, após clicar na seta você pode passar com o mouse por cima dos gráficos e textos do site, vai observar que vão aparecer blocos coloridos conforme você desliza pobre as informações.
Ao clicar sobre um deles como a área de pesquisa, por exemplo. Observe no código ao lado do símbolo “<” está a palavra input, esta é a palavra que representa a tag que coleta dados do usuário.
No entanto, apesar do site ter encontrado um input, o conteúdo do input pode não ser o mesmo da nossa pesquisa, isso pode acontecer quando temos mais de um input no código. Qual deles é o correto para coletarmos?

Como encontrar o input correto?
Para isso vamos ter que fazer uma busca de forma mais generalizada, ao invés de usar o find vamos usar o find_all.
titulo = site.find(“title”)

Print(titulo)

pesquisa = site.find_all("input")

# print(pesquisa[1])
Usando o find_all vamos ter como resultado uma lista com todos os inputs da página, todos os disponíveis no código, agora só resta achar o que tem a frase da nossa busca e esse será o input que estamos procurando.
Neste caso, lendo os inputs, vemos que o input que queremos é o segundo dessa lista, mas, e se o site modificar isso e o input passar a ser o primeiro ou o terceiro da lista, nosso código pode deixar de funcionar?
Sim, isso pode acontecer…
Isso porque, o BeautifulSoup traz as informações do site e depois disso as trata, então é preciso trabalhar com sites estáticos como o Google, a maioria dos sites de notícias.
Sites como o YouTube que não carregam todo o conteúdo de uma só vez e sempre tem mais informações à medida que você desce a barra ou sites onde você tem interação com coleta de senhas NÃO são indicados para o BeautifulSoup e essa é uma desvantagem da ferramenta.
Uma vantagem é que o BeautifulSoup faz a busca de uma maneira padrão, então se você trocar o link, ele consegue coletar as mesmas informações de qualquer página usando a mesma estrutura.
Outra vantagem do BeautifulSoup é ser rápido para coletar dados e a desvantagem como falamos é servir apenas para sites estáticos, se você quiser trabalhar com sites dinâmicos você terá que usar outra ferramenta como o Selenium, por exemplo.
Mudança de Posição do Input
Vamos imaginar que o input que estava em segundo lugar na lista que pesquisamos usando o find_all, agora não é mais o segundo. Uma forma de pesquisar este input de modo a sempre encontrar o correto é usando mais de uma característica daquele input na busca, perceba que a linha de código do input possui muitas outras características, podemos usar a class, por exemplo.
pesquisa2 = site.find("input", class_="gLFyf")

print(pesquisa2)
Obs. Sempre que pesquisar por class você deve colocar o underline -> class_ -> isso porque class é uma palavra usada no Python para identificação, portanto para pesquisar class como uma característica do código do site para uma busca é necessário fazer essa diferenciação.
Importante -> este código acima onde colocamos 2 características do input vai dar um erro quando executado, por quê?
Isso ocorre porque o navegador consegue saber que você está pedindo esta requisição por meio do Python e isso causa o erro, se a requisição viesse de outro navegador a pesquisa seria feita de forma correta. Como resolvemos isso?
Você precisa fazer o navegador entender que a requisição vem de um navegador, porque assim ele te entrega o resultado no formato correto, no formato de Python algumas informações podem vir faltando.
Volte na página do site e clique novamente com o botão direito -> inspecionar -> vá na guia Network -> dentro de Network você vai ver várias listas, se não aparecerem, clique em f5 para verificar as listas, feito isso, clique em qualquer uma dessas linhas de código.
Dentro desta linha vai haver a parte de Request URL, Request Method e Request Headers, este último é o que estamos procurando.
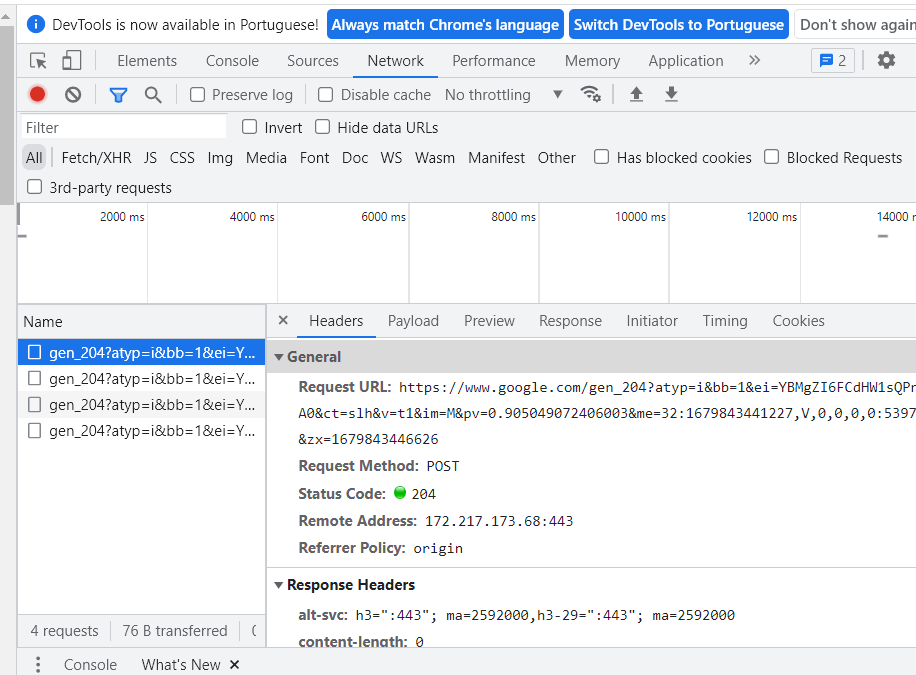
Dentro de Request Headers você vai encontrar a parte de user-agent, esta é a linha que diz qual a versão do navegador que estamos pedindo.
user-agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/111.0.0.0 Safari/537.36Vamos precisar passar essa informação para o código:
import requests

from bs4 import BeautifulSoup

link = "https://www.google.com/search?q=cotacao+dolar"

headers = {"User-Agent": <strong>"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/111.0.0.0 Safari/537.36"</strong>}
Agora só precisamos colocar o Headers na requisição:
requisicao = requests.get(link, headers=headers)

print(requisicao)
Nosso código já consegue encontrar o input correto agora, com uma chance muito menor de erro.
Mais um Exemplo: Como pegar a informação do valor do Dólar usando tudo que já vimos nesta aula!
cotacao_dolar = site.find("span", class_="SwHCTb")

print(cotacao_dolar.get_text()) -> pega a informação em formato de texto (valor arredondado)

print(cotacao_dolar["data-value"]) -> busca a cotação do site (valor com mais casas decimais)
Perguntas frequentes
1. Qual a diferença entre find e find_all no BeautifulSoup?
O find retorna apenas a primeira ocorrência da tag pesquisada, como site.find(“title”). O find_all devolve uma lista com todas as ocorrências, útil quando a página tem vários elementos iguais, como diversos inputs. Com a lista em mãos, você identifica pelo índice ou refina a busca por classe.
2. Por que usar class_ em vez de class no BeautifulSoup?
Porque class é uma palavra reservada do Python e não pode virar nome de argumento. Por isso a busca por classe usa o underline: site.find(“input”, class_=“gLFyf”). Combinar tag e classe deixa o código mais estável, já que ele não depende da posição do elemento na lista.
3. Como evitar bloqueio ao raspar dados com o BeautifulSoup?
Alguns sites entregam um conteúdo diferente quando percebem que a requisição veio do Python. A solução é enviar um cabeçalho User-Agent de navegador no requests.get. Copie o valor em Inspecionar > Network > Request Headers e passe no parâmetro headers, como um dicionário, junto com o link.
4. Em quais sites o BeautifulSoup funciona melhor?
Ele é rápido e ideal para sites estáticos, que já entregam todo o conteúdo no HTML — buscadores e portais de notícia, por exemplo. Páginas que carregam dados conforme você rola a tela, como o YouTube, ou que exigem login pedem outra ferramenta, como o Selenium, que controla o navegador.
Conclusão – Introdução ao BeautifulSoup
Pessoal, fiz esta aula para mostrar a vocês o máximo de informações possíveis para uma boa introdução ao BeautifulSoup, conseguimos ver o que podemos fazer com a ferramenta.
Então, nesta aula aprendemos como usar a ferramenta, como trabalhar dentro do site, os possíveis erros e qual tipo de site podemos usar.
Espero que gostem, a Introdução ao BeautifulSoup é mais um conhecimento para aplicar nos seus projetos!
Até breve! Abraço,
Hashtag Treinamentos
Para acessar outras publicações de Python, clique aqui!