
Previsão da Copa 2026 com Python: quem é o favorito?
Veja como um modelo de previsão da Copa 2026 com Python simulou 50 mil Mundiais para apontar o provável campeão e as chances reais do Brasil.
O que você vai ver aqui?
Introdução
Fazer a previsão da Copa 2026 com Python parece coisa de outro mundo, mas é exatamente isso que dá para construir com estatística, um pouco de código e a ideia certa. Em vez de chutar quem vai levantar a taça, a proposta aqui foi montar um modelo que simula a Copa do Mundo inteira milhares de vezes e, a partir disso, calcula a probabilidade real de cada seleção chegar em cada fase, passar de etapa e, no fim, ser campeã.
E não é só promessa. Em 2023, um modelo parecido feito em Python previu o Campeonato Brasileiro ainda faltando dez rodadas e cravou as duas perguntas que importavam: o Palmeiras seria campeão e o Vasco escaparia do rebaixamento. Agora o desafio subiu de nível, porque prever uma Copa do Mundo, que acontece de quatro em quatro anos, é bem mais difícil do que prever um campeonato de pontos corridos.
Neste artigo, você vai ver o que o modelo apontou para 2026, quais são as chances do Brasil em cada etapa e, principalmente, como tudo isso funciona por dentro: do histórico de jogos das seleções até a simulação de Monte Carlo. No fim, você ainda descobre quais ferramentas de Python tornam esse projeto possível e como rodar e adaptar tudo no seu próprio computador.
Para fazer o download do(s) arquivo(s) utilizados na aula, preencha com o seu e-mail:
Não vamos te encaminhar nenhum tipo de SPAM! A Hashtag Treinamentos é uma empresa preocupada com a proteção de seus dados e realiza o tratamento de acordo com a Lei Geral de Proteção de Dados (Lei n. 13.709/18). Qualquer dúvida, nos contate.
O que um modelo em Python revelou sobre o campeão da Copa 2026
Antes de entrar na parte técnica, vamos direto ao que interessa: o resultado. Depois de simular 50 mil vezes a Copa do Mundo de 2026, a seleção que aparece como campeã mais provável é a Espanha, com quase 16% de chance de título. Logo atrás vêm Argentina, França e Brasil, formando o grupo de favoritos.
Uma coisa precisa ficar clara desde já, porque é o ponto mais importante para entender qualquer previsão probabilística: 15,9% de chance de título não significa que a Espanha vai ser campeã. Significa apenas que, das 50 mil Copas simuladas, ela terminou com a taça em cerca de 15,9% delas. Na maioria absoluta das simulações, quem ganhou foi outra seleção. Por isso esse tipo de modelo é mais honesto do que alguém que simplesmente crava um campeão no início do torneio.
Para você visualizar, este é o topo do ranking de favoritos segundo o modelo:
| Posição | Seleção | Chance de título | Chance de chegar à final |
|---|---|---|---|
| 1º | Espanha | 15,9% | 25,1% |
| 2º | Argentina | 14,5% | 23,3% |
| 3º | França | 10,7% | 18,5% |
| 4º | Brasil | 9,4% | 16,8% |
| 5º | Inglaterra | 8,3% | 15,2% |
| 6º | Portugal | 6,7% | 13,2% |
As chances de cada seleção (e do Brasil) fase a fase
Mais legal do que saber só quem é o favorito é conseguir acompanhar a jornada de cada seleção etapa por etapa. Como o modelo simula a Copa inteira, ele entrega a probabilidade de cada time se classificar da fase de grupos, chegar às oitavas, quartas, semifinais, final e título. Isso é ouro para quem quer montar um bolão com critério em vez de pura intuição.
Quanto o modelo dá para o Brasil ser campeão
O Brasil, no grupo C, aparece em quarto lugar entre os favoritos. As chances dele em cada etapa ficaram assim: 98,5% de se classificar da fase de grupos, 67,8% de passar pelas oitavas, 46,8% de chegar às quartas, 29,3% de alcançar as semifinais, 16,8% de disputar a final e 9,4% de ser campeão.
Repare no contraste entre os números. A classificação é quase certa, mas a chance de título é de menos de 10%, e isso faz todo sentido: cada mata-mata é um filtro novo, e a probabilidade vai caindo a cada confronto contra adversários cada vez mais fortes. É a matemática mostrando, sem paixão, o tamanho do desafio.
Probabilístico x determinístico: por que o favorito nem sempre vence
Aqui mora uma sutileza que confunde muita gente. Existem duas formas de olhar para o resultado. A primeira é a probabilística, que é a das 50 mil simulações: cada porcentagem é a fração das simulações em que aquilo aconteceu. A segunda é a determinística, em que você pega a força de cada seleção, monta um único chaveamento e faz o favorito de cada jogo avançar até o fim.
Esses dois caminhos podem dar campeões diferentes, e o motivo é o chaveamento. Imagine que Espanha e Argentina, as duas mais fortes, caiam no mesmo lado da chave e se enfrentem já nas oitavas. Uma das duas cai cedo, por mais forte que seja. Quando isso entra na conta, a chance de uma seleção um pouco mais fraca terminar à frente delas no ranking aumenta. No cenário determinístico ilustrativo do projeto, por exemplo, as semifinais seriam Espanha contra França e Brasil contra Argentina, com a Espanha batendo a Argentina por 1 a 0 na decisão. Já o ranking robusto, aquele que vale de verdade, é o das probabilidades.
 Python Impressionador
Você vai aprender a linguagem de Programação que mais cresce no Mundo para fazer automações incríveis, desenvolver sites, fazer análises de dados, trabalhar com Ciência de Dados, Inteligência Artificial, mesmo que você nunca tenha tido nenhum contato com Programação na vida.
Começar agora


Como o modelo de previsão funciona, passo a passo
Agora vem a parte que realmente importa para quem quer aprender: como construir isso tudo. A boa notícia é que o projeto se apoia em blocos bem definidos, e dá para entender cada um deles sem se afogar em matemática pesada. Vamos do começo.
Tudo começa com o histórico de jogos das seleções
O ponto de partida é uma base de dados pública com o histórico de partidas de seleções desde 1872. São quase 49 mil jogos, vindos do projeto aberto martj42/international_results, que reúne data, placar, tipo de competição e local de cada partida. A premissa do modelo é simples e poderosa: o histórico de jogos de uma seleção diz o quão forte ela é hoje.
Vale lembrar o contexto do torneio que estamos prevendo. A Copa do Mundo de 2026 é a primeira com 48 seleções, divididas em 12 grupos, com 104 partidas no total e três países-sede: Estados Unidos, Canadá e México. Esse formato novo muda o chaveamento e precisa estar refletido na simulação.
Por que jogos recentes e Copas pesam mais
Nem todo jogo do histórico vale a mesma coisa. Um amistoso de 2003 não pode pesar igual a uma partida de Copa do ano passado, simplesmente porque a seleção de hoje quase não tem relação com a de duas décadas atrás. Para resolver isso, o modelo aplica dois ajustes ao peso de cada partida.
O primeiro é o decaimento temporal com meia-vida de 2,5 anos. Pensa assim: cada jogo começa valendo 1 e, a cada 2,5 anos que passam, o peso dele cai pela metade. Um jogo de 2026 vale 1, um de 2024 vale por volta de 0,5, um de 2022 cerca de 0,25 e assim por diante. Quanto mais antigo, menos relevante. O segundo ajuste é a importância da competição: a Copa do Mundo pesa 1,00, torneios como Copa América e Eurocopa ficam em 0,90, eliminatórias em torno de 0,80 e amistosos valem apenas 0,50. Afinal, ninguém entra em campo num amistoso com a mesma tensão de uma Copa.
Dixon-Coles e a distribuição de Poisson para estimar placares
Com a força de cada seleção calculada, o próximo passo é transformar isso em placares prováveis. É aqui que entram a distribuição de Poisson e o modelo Dixon-Coles. A ideia é estimar quantos gols cada lado tende a fazer, combinando a força de ataque de uma seleção com a fragilidade defensiva da outra, e ainda considerando o mando de campo.
Esse cálculo entrega uma média esperada de gols, por exemplo dois para um lado e três para o outro. Só que essa média não é o resultado final: ela é o ponto de partida. A distribuição de Poisson pega essa média e devolve a probabilidade de cada placar possível, de 0 a 0 até um teto de 10 gols definido no projeto. Com a distribuição de gols das duas seleções, monta-se uma matriz de probabilidades que cruza todos os placares imagináveis.
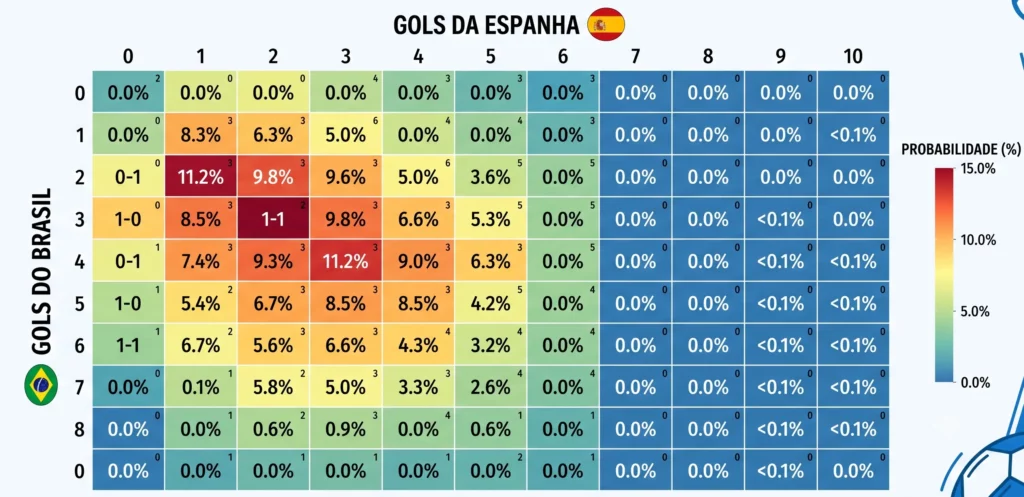
E por que Dixon-Coles, e não só Poisson puro? Porque a Poisson tradicional erra a frequência de placares baixos, como 0 a 0, 1 a 0 e 1 a 1, que são justamente os mais comuns no futebol. O modelo Dixon-Coles adiciona uma correção para esses resultados, deixando a previsão mais fiel à realidade. Se você quiser se aprofundar na matemática por trás disso, este tutorial clássico sobre Dixon-Coles e ponderação temporal explica o passo a passo com código.
O reforço do rating Elo
Além do modelo de gols, o projeto calcula um rating Elo para cada seleção, aquela mesma lógica de pontuação usada no xadrez e em jogos online. Todas as seleções começam com 1500 pontos e, conforme o histórico de jogos avança, esse número sobe ou desce de acordo com os resultados. É como criar um ranking próprio, parecido com o da FIFA, mas construído a partir dos dados.
A probabilidade final de cada jogo mistura as duas fontes: 80% vêm do modelo Dixon-Coles e 20% do Elo. Curiosamente, em testes de validação o Elo fez pouca diferença, ajudou um pouco na previsão da Copa de 2018 e foi praticamente igual em 2022, mas foi mantido como um estabilizador do modelo. Esse cuidado de testar antes de confiar é o que separa um projeto sério de um chute sofisticado.
Vale um parêntese sobre o processo, porque ele faz parte da história desse projeto. Montar todo esse código na mão, com o modelo de gols, o cálculo de Elo e a combinação dos dois, levaria muito tempo. Boa parte da construção foi acelerada com o apoio do Claude Code, um assistente de inteligência artificial para programação, usado para discutir as melhores estratégias de cada etapa e escrever código mais rápido. É um bom retrato de como a IA virou aliada de quem trabalha com dados, sem substituir o entendimento de quem está no comando do projeto.
Simulação de Monte Carlo: 50 mil Copas de uma vez
Chegamos ao coração do projeto. Com a probabilidade de cada placar em mãos, como sair do resultado mais provável para a chance real de uma seleção ser campeã? A resposta é a simulação de Monte Carlo. A lógica é a seguinte: para cada jogo, o programa sorteia um placar respeitando a matriz de probabilidades. Resultados prováveis saem mais vezes, mas os improváveis também podem acontecer, exatamente como no futebol de verdade.
Uma analogia ajuda a fixar a ideia. Imagine que você queira saber sua chance de acertar o centro de um alvo jogando dardos. Calcular isso na fórmula é difícil, então você simplesmente joga 10 mil dardos e observa onde eles caem. A nuvem de pontos revela a probabilidade. Monte Carlo faz a mesma coisa com a Copa: simula o torneio inteiro 50 mil vezes, seguindo o chaveamento oficial até a final. Se o Brasil é campeão em 5 mil dessas 50 mil simulações, dizemos que ele tem 10% de chance de título. É essa repetição em massa que torna o modelo robusto, porque ele considera até os cenários menos prováveis.
Pontos fortes e limites de um modelo de previsão de futebol
Nenhum modelo é perfeito, e reconhecer isso é parte de fazer ciência de dados com responsabilidade. Vale a pena olhar para os dois lados antes de tirar conclusões.
Por que ele é confiável
- É baseado em 50 mil simulações sobre um histórico de jogos reais, e não no palpite de uma única pessoa.
- Usa métodos consagrados na estatística esportiva, como Dixon-Coles, Poisson, Elo e Monte Carlo, em vez de achismo.
- Entrega probabilidades, não cravadas, o que é uma forma mais transparente de comunicar incerteza.
- Dá mais peso a jogos recentes e a competições importantes, refletindo melhor a fase atual de cada seleção.
Onde o modelo pode errar
- A Copa acontece de quatro em quatro anos, então existem poucas amostras do evento que queremos prever.
- Fatores humanos como lesões, nervosismo e ausência de um craque não entram no modelo.
- Pela natureza da distribuição de Poisson, ele tende a prever placares baixos, subestimando goleadas como 4 a 1.
- Os pênaltis são tratados quase como sorte, sem considerar a qualidade do goleiro em cobranças.
- Ele não usa as odds das casas de apostas, que agregam a opinião de milhares de pessoas e poderiam refinar a previsão.
Esse último ponto é interessante e vale uma reflexão. A previsão de uma só pessoa erra bastante, mas a média de milhares de palpites costuma chegar surpreendentemente perto do resultado real. É o fenômeno da sabedoria das multidões, e incorporá-lo seria uma evolução natural do modelo.
As ferramentas de Python por trás da previsão
Se você chegou até aqui pensando que precisaria de dezenas de bibliotecas complicadas, pode relaxar. O projeto inteiro se sustenta com pouquíssimas ferramentas, e isso é uma ótima notícia para quem está começando.
penaltyblog, NumPy e pandas
A estrela do projeto é a biblioteca penaltyblog, criada justamente para análise e previsão de futebol. Ela já traz prontos o modelo Dixon-Coles e o cálculo de Elo, então o trabalho foi mais ajustar esses recursos do que reinventar a roda. Para a parte numérica pesada, entra a biblioteca NumPy, que cuida das operações com matrizes de forma eficiente, como a criação da matriz de probabilidades de placares.
Para organizar e manipular os dados em tabelas, o projeto usa o pandas, a principal ferramenta de análise de dados do Python, construída por cima do próprio NumPy. Esses dois costumam andar de mãos dadas em qualquer projeto de dados. Se quiser um panorama mais amplo do ecossistema, vale conferir este guia das principais bibliotecas Python. Além delas, o projeto usa apoios pontuais como SciPy, PyYAML, para ler o arquivo de chaveamento, e Matplotlib, para algumas decisões de otimização.
Como rodar e adaptar o projeto no seu computador
A melhor parte é que esse modelo não fica preso na tela de quem o criou. Você pode baixar o projeto, abrir a pasta no VS Code ou no editor que preferir e instalar as dependências com um único comando no terminal: pip install -r requirements.txt. Depois, é só executar o arquivo run.py para o modelo carregar o histórico, ajustar tudo e rodar as 50 mil simulações.
E se você quiser experimentar suas próprias hipóteses, basta abrir o arquivo config.py, onde ficam todas as regras ajustáveis. Dá para mudar o decaimento temporal, alterar o peso das competições, cortar o histórico para usar só os últimos anos ou trocar o equilíbrio entre Dixon-Coles e Elo. Mexa em um parâmetro, rode de novo e veja como as probabilidades mudam. É assim, testando e observando, que você realmente aprende análise de dados.
Conclusão
Construir uma previsão da Copa 2026 com Python mostra na prática o que a análise de dados tem de mais fascinante: pegar um problema cheio de incerteza, como adivinhar o campeão de um Mundial, e transformá-lo em probabilidades que fazem sentido. Você viu que não há mágica nem bola de cristal, apenas histórico de jogos bem ponderado, um bom modelo estatístico e a força bruta de 50 mil simulações trabalhando a seu favor.
E o melhor é que tudo isso está ao seu alcance. As mesmas ferramentas usadas aqui, Python, pandas e NumPy, são a base de praticamente qualquer projeto de dados no mercado. Se você quer sair do zero e aprender a criar análises e modelos como esse, comece pelo seu primeiro grande projeto: conheça o Python Impressionador e dê o passo que transforma curiosidade em habilidade de verdade.
Caso prefira esse conteúdo no formato de vídeo-aula, assista ao vídeo abaixo ou acesse o nosso canal do YouTube!
FAQ - Perguntas Frequentes sobre previsão da Copa 2026 com Python
1. Quem é o favorito ao título da Copa 2026 segundo o modelo?
A Espanha, com cerca de 15,9% de chance de título nas 50 mil simulações. Em seguida vêm Argentina (14,5%), França (10,7%) e Brasil (9,4%).
2. Quais são as chances do Brasil ser campeão?
O modelo aponta 9,4% de chance de título, deixando o Brasil em quarto lugar entre os favoritos, apesar de 98,5% de chance de passar da fase de grupos.
3. Preciso saber muita matemática para criar um modelo desses?
Não. Bibliotecas como a penaltyblog já cuidam da parte estatística mais pesada. Com Python básico e noções de pandas e NumPy, você já consegue montar e adaptar um projeto assim.
4. O que é uma simulação de Monte Carlo?
É um método que simula um evento milhares de vezes respeitando as probabilidades de cada resultado. Em vez de uma fórmula fechada, você observa o que acontece na maioria dos cenários para estimar as chances.
5. O modelo garante o resultado da Copa?
Não, e essa é a graça. Ele trabalha com probabilidades, não com certezas. O objetivo é estimar quem tem mais chance, sabendo que zebras fazem parte do futebol e do próprio modelo.
Hashtag Treinamentos
Para acessar outras publicações de Python, clique aqui!
Posts mais recentes de Python
- Curso Básico de Python: Saia do Zero em 10 Aulas Grátis
 Aprenda com o curso básico de Python gratuito da Hashtag: 10 aulas práticas, exercícios e projetos reais para sair do zero em programação.
- Agentes RAG com Python: como criar um assistente de IA
 Aprenda a criar Agentes RAG com Python do zero: LangChain, FAISS e OpenAI para montar um assistente de IA que responde com base nos seus documentos.
- 25 Tipos de Gráficos em Python: Guia Completo com Código
 Aprenda a criar os principais tipos de gráficos em Python com Plotly: barras, pizza, mapas e mais, com código pronto para copiar e usar.


Posts mais recentes da Hashtag Treinamentos
- Planilha de Controle de Notas Fiscais no Excel [Grátis]
 Baixe a planilha de controle de notas fiscais no Excel grátis: calcule ISS e retenções, veja o que está em aberto e gere a cobrança de cada nota de serviço.
- Qual IA usar na empresa: ChatGPT, Claude ou Perplexity?
 Qual IA usar na empresa: veja as diferenças entre ChatGPT, Claude e Perplexity e quando cada um rende mais em cada área da sua equipe.
- Apostilas Gratuitas em PDF: Excel, Power BI, Python e IA
 Baixe apostilas gratuitas em PDF de Excel, Power BI, Python, Claude e agentes de IA, com exercícios e gabarito. Escolha a sua e comece hoje.


