LogoHashtagProgr
LogoCienciadeDados1

Conheça o Curso
Ciência de Dados Impressionador

Leia a página para conhecer tudo da formação

A oferta do Ciência de Dados Impressionador se encerra em:

00

Dias

:

00

Horas

:

00

Minutos

:

00

Segundos

Atom ICO Fl
01Loc

Pagamento Seguro

Ambiente seguro.
Seus dados estão protegidos e sua compra é 100% segura.

Ico imediato

Acesso Imediato e por 2 anos

Seu login e senha são enviados por e-mail logo após o pagamento. Você tem acesso imediato e por 2 anos.

Ico garantia

7 dias de Garantia

‍Você poderá pedir a devolução de 100% do seu dinheiro dentro desse prazo. Sem perguntas, livre de risco.

Ico conteudo

+260h de Conteúdo

Vídeo aulas, Exercícios, Projetos Reais e Apostila. Todas as semanas adicionamos aulas novas

05 icoDash

Projetos Reais

Vamos construir juntos projetos nas mais diversas áreas da Ciência de Dados para montar o seu portfólio

Ico suporte

Suporte a dúvidas

‍Dúvidas respondidas individualmente todo dia útil. Tanto dúvidas de aula quanto dúvida dos seus desafios em Power BI.

A demanda por profissionais que dominam Ciência de Dados só cresce

Isso porque a Ciência de Dados é um dos conhecimentos que está entrando pra lista dos mais desejados pelas empresas, e elas estão literalmente disputando por profissionais de Ciência de Dados.

C01
C02
C03
C04

Empresas gigantes no Brasil e no mundo implementam Ciência de Dados

Marcas CD

Como funciona a dinâmica para aprender Ciência de Dados

Pilar 1:
Tecnologia

O primeiro pilar de um Projeto de Ciência de Dados é a tecnologia/programação para executar o projeto. Aqui vamos te dar toda a base necessária de Python, a linguagem mais utilizada no mundo para Ciência de Dados. E importante - vamos te ensinar do absoluto zero. Mesmo que você não saiba nada de Python e nem nunca tenha programado na vida. ‍

Pandas, Numpy, Matplotlib; diferentes modelos de Machine Learning, Análise de erro, Feature Engineering, e MUITO mais.

Pilar 2: 
NEgócios

Ciência de Dados não é aprender a copiar código, não é clicar botão. É ser capaz de olhar para uma área, uma empresa, e construir a melhor solução para um desafio usando os dados disponíveis. Por isso, vamos te passar toda a visão de negócios.

Desde Análises de bases reais; Análise exploratória de dados; apresentações executivas; práticas de visualização e data storytelling; visualizações dinâmicas, e MUITO mais.

Pilar 3:
Estatística

Aqui você vai aprender toda a base de análise, que também vamos te ensinar do zero. Introdução à Estatística; estatística descritiva; Assimetria e curtose, Viés e Variância e MUITO mais.

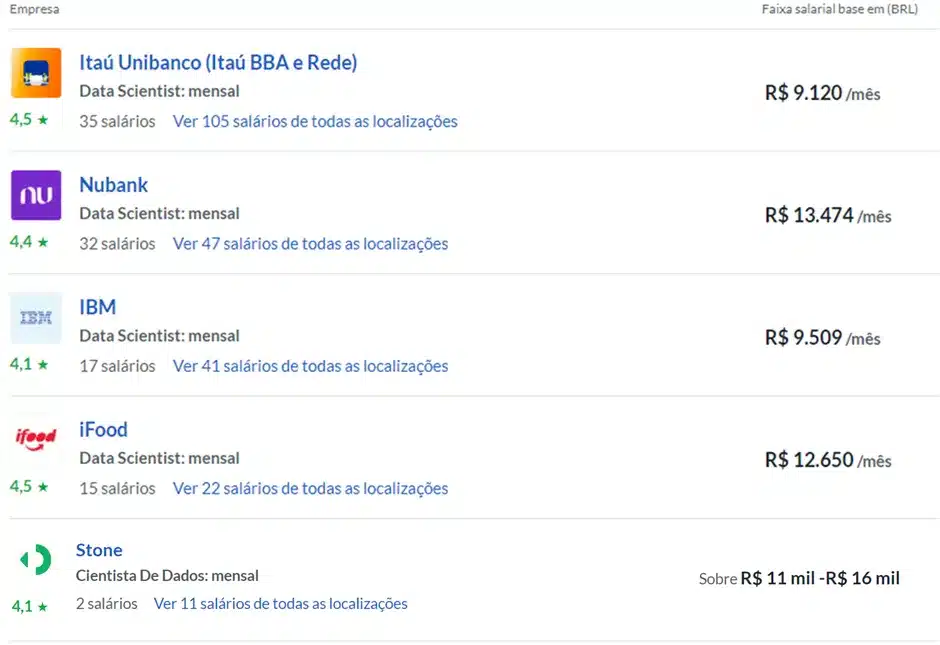
Uma das habilidades mais requisitadas no mercado atualmente

Quando você aprende a usar Ciência de Dados para a realidade do que as empresas precisam, você se destaca de todo mundo.

Aprender Ciência de Dados não é aprender meia dúzia de códigos. A maioria das pessoas aprende a criar um projeto simples sem aplicações práticas e “acha que sabe” Ciência de Dados.

SalarioCD
VagasCD

É por isso que existem centenas de vagas abertas nesse momento esperando por profissionais qualificados para serem preenchidas.

Você precisa aprender a criar projetos que te permitam analisar dados e gerar insights relevantes para as empresas, porque esse é o desafio que vão esperar de você no Mercado de Trabalho.

Por que o Ciência de Dados Impressionador é
realmente diferente?

Atom ICO Fl
Check P BI

Didática e ZERO pré-requisitos

Um dos grandes pilares da Hashtag Treinamentos é a didática.

Aprender Ciência deDados pode ser simples e prático e você não precisa saber nada para começar.

Com mais de 5 mil alunos satisfeitos com o Ciência de Dados Impressionador, podemos afirmar sem medo: você COM CERTEZA vai conseguir aprender, independente do seu nível atual.

Check P BI

Pode ser aplicado em qualquer área

Sem papo de vendedor, o que vamos te ensinar no Ciência de Dados Impressionador pode realmente ser aplicado em qualquer empresa e em qualquer área.

Toda empresa precisa analisar dados e tirar insights valiosos das suas informações e isso vamos te ensinar a fazer de forma que impressiona.

O melhor: mesmo que atualmente a sua empresa ou a sua área não use Ciência de Dados, você vai conseguir se destacar por causa do Ciência de Dados Impressionador.

Check P BI

Te ensinamos a pensar, e a criar projetos para transformar os dados em insights valiosos para a empresa

A formação foi totalmente pensado na sua evolução, passo a passo, para você não aprender “só” a criar códigos, mas sim a aprender sem ficar decorando nada e a criar uma linha de raciocínio para resolver desafios reais das empresas.

Vamos te ensinar a fazer o que chamamos de uma “Análise Perfeita”, como apresentar seus dados usando Storytelling, e muito mais.

Check P BI

Mais de 10 Projetos Práticos em diferentes áreas de aplicação

A formaçãoconta aplicações reais e exemplos de diferentes áreas para você se inspirar, copiar, replicar o que quiser, e usar como referência para aplicar na sua atual ou futura empresa.

Alguns exemplos:
Projeto de Algoritmo de Classificação de Fraude com Inteligência Artificial
Projeto de Apresentação Executiva para Ciência de Dados
Projeto de Análise de Sentimento em Avaliação de Compra
Projeto de Deep Learning para Reconhecimento de Imagem
Projeto de Criação de Algoritmo de Recomendação
Projeto de clusterização de clientes
Projeto com criação de score de crédito de clientes
E MUITO mais...

Você vai sair da formação com um verdadeiro Portfólio de Projetos de Ciência de Dados pra colocar no currículo e/ou poder apresentar na sua empresa.

Check P BI

Exemplos reais e práticos desde o início

Acreditamos que exemplos práticos são a melhor forma de aprender. Mesmo nos módulos mais básicos a formação é sempre preocupado em contextualizar como aquilo pode ser aplicado na realidade do mercado.

Não vamos ficar fazendo exemplos aleatórios, todos os exercícios da formação são contextualizados e aplicados na realidade do Mercado

Check P BI

Você NUNCA está sozinho

Suporte todo dia útil a qualquer dúvida que você tenha para você nunca ficar travado em nada.

Temos uma equipe de experts disponível pra te ajudar respondendo dúvidas individualmente.

Seja dúvida sobre alguma aula, seja dúvida sobre algum código que está tentando fazer.

Para quem é essa formação?

Essa formação foi desenhada 2 tipos de pessoas

Ico qbi 01

PARA QUEM

Quer usar Ciência de Dados para passar em um processo seletivo, conseguir um emprego ou mudar de área

Ico qbi 2

PARA QUEM

Quer usar Ciência de Dados para se destacar na sua empresa, seja para mudar de área, para ser promovido ou impressionar seu chefe

Independente do seu nível atual

Lv01

Zerados

‍Se você não sabe nada de Ciência de Dados ou até já tentou aprender Ciência de Dados e não deu certo, essa formação é para você.

Vamos te ensinar absolutamente TUDO, partindo do zero mesmo, com uma didática que você não vai encontrar em nenhum outra formação. Não tem nenhum pré-requisito. Você não precisa ter nenhum tipo de formação para aprender Ciência de Dados.

Mulher pro

Iniciantes

Se você já começou seus estudos e ainda se sente básico em Ciência de Dados, essa formação vai ser excelente para você.

Você vai ver a sua evolução ser muito mais rápida e de forma muito mais fácil do que atualmente. A cada semana da formação você vai aprender (aprender mesmo, de verdade) o equivalente a 1 mês de estudo. Isso é possível por conta de 3 pilares do Ciência de Dados Impressionador: Didática, Exemplos Reais e Suporte Constante da nossa equipe.

Senior

Quem já sabe mais

‍Se você já sabe criar projetos de Ciência de Dados ou pelo menos já sabe o "essencial", essa vai ser a única formação que você vai encontrar com o que você realmente precisa para deslanchar.

Isso porque o Ciência de Dados Impressionador é realmente voltado para a prática das empresas, então vamos te mostrar tudo o que falta para você conseguir impressionar com Ciência de Dados e resolver qualquer desafio.

Material Didático

Todo o material foi pensado para te guiar passo a passo por cada etapa

Mockup CD
CirculoCD

O que você
vai aprender?

Veja a Ementa Completa do Ciência de Dados Impressionador

A única formação realmente completa de Ciência de Dados e 100% voltado para a prática do dia-a-dia das empresas

Degrade mod pb
  • Módulo 1 - Introdução à Ciência de Dados

    1. Apresentação do Módulo
    2. Definição de Ciência de Dados
    3. Conceito Simplificado de Ciência de Dados
    4. Os 3 Pilares da Ciência de Dados
    5. Definindo Ciência e Algoritmo
    6. Definindo Estatística e Método Científico
    7. Definindo Processos e Sistemas
    8. De Dados até Inteligência de Negócios
    9. Exemplo Prático - Pequena Loja De Roupas
    10. Tipos de Dados
    11. O Método da Ciência de Dados - CRISP-DM
    12. Análise x Ciência x Engenharia de Dados
    13. Revisão e Considerações Finais

  • Módulo 2 - Python Básico

    1. Por que Python?
    2. Instalando o Python no Windows
    3. Problemas na Instalação - Resolvido
    4. Mac, Linux e Google Colab
    5. Jupyter vs JupyterLab
    6. Atalhos úteis
    7. Markdown em arquivos Notebook
    8. Principais operações matemáticas com Python - parte 1
    9. Principais operações matemáticas com Python - parte 2
    10. Trabalhando com texto - strings
    11. Variáveis - parte 1
    12. Variáveis - parte 2
    13. Comparações - parte 1
    14. Comparações - parte 2 - operador and e or
    15. Verificando o tipo de variáveis
    16. Funções built-in
    17. Exercícios - enunciados
    18. Exercícios - resolução
    19. Tipos sequenciais - introdução
    20. Tipos sequenciais - listas - parte 1 - índices e mutabilidade
    21. Tipos sequenciais - listas - parte 2 - slices
    22. Tipos sequenciais - listas - parte 3 - slices
    23. Tipos sequenciais - listas - parte 4 - adicionando e removendo itens
    24. Tipos sequenciais - tuplas
    25. Tipos sequenciais - listas vs tuplas
    26. Tipos sequenciais - strings
    27. Dicionários - introdução
    28. Dicionários - consultando chaves
    29. Dicionários - alguns métodos de dicionários
    30. Dicionários - exemplos de uso
    31. Exercícios - enunciados
    32. Exercícios - resolução
    33. Desafios - enunciados
    34. Desafios - resolução
    35. Formatação de strings - marcadores de posição (evite usar)
    36. Formatação de strings - método format - parte 1
    37. Formatação de strings - método format - parte 2
    38. Formatação de strings - f-strings
    39. Métodos de strings
    40. Exercícios - enunciados
    41. Exercícios - resolução - parte 1
    42. Exercícios - resolução - parte 2
    43. Condicionais - if
    44. Condicionais - if/else
    45. Condicionais - if/elif/else
    46. Condicionais - aninhamento
    47. Condicionais - uso de operadores
    48. Condicionais - revisão
    49. Condicionais - exercícios - enunciados
    50. Condicionais - exercícios - resolução
    51. Loops - For - introdução
    52. Loops - For - exemplos simples
    53. Loops - For - dicionários
    54. Loops - For - range - introdução
    55. Loops - For - range - exemplos
    56. Loops - For - enumerate
    57. Loops - For - zip
    58. Loops - For - comprehensions
    59. Loops - While - introdução
    60. Loops - While - exemplos e break
    61. Try/except
    62. Loops e try/except - exercícios - enunciados
    63. Loops e try/except - exercícios - resolução - parte 1
    64. Loops e try/except - exercícios - resolução - parte 2
    65. Desafio - enunciado e primeira resolução
    66. Desafio - enunciado e segunda resolução
    67. Funções - introdução
    68. Funções - definição, docstrings, retorno
    69. Funções - valores padrão, parâmetros explícitos
    70. Funções - funções com mais de um retorno
    71. Funções - exercícios - enunciados
    72. Funções - exercícios - resolução - parte 1
    73. Funções - exercícios - resolução - parte 2
    74. Classes - introdução
    75. Classes - exemplo
    76. Classes - funções vs classes
    77. Classes - exercícios - enunciados
    78. Classes - exercícios - resolução - parte 1
    79. Classes - exercícios - resolução - parte 2
    80. Módulos - introdução
    81. Módulos - biblioteca padrão
    82. Módulos - módulos de terceiros
    83. Módulos - exercícios - enunciados e instalação de pacote
    84. Módulos - exercícios - resolução
    85. Encerramento do módulo

  • Módulo 3 - Numpy

    1. Orientações - Assista antes de começar
    2. Arrays Numpy vs Listas
    3. Array Explicado
    4. Funções Básicas de Array
    5. Exercícios Array
    6. Aleatórios e Estatística
    7. Where no Numpy
    8. Exercícios Numpy - Parte 1
    9. Exercícios Numpy - Parte 2
    10. Reshape
    11. Exemplo Reshape
    12. Exercícios Numpy - Parte 3
    13. Exercícios Numpy - Parte 4

  • Módulo 4 - Pandas

    1. Introdução ao Pandas
    2. DataFrames
    3. Importando uma base de dados
    4. Principais checagens - parte 1
    5. Principais checagens - parte 2
    6. Principais checagens - parte 3
    7. Selecionando partes - parte 1
    8. Selecionando partes - parte 2
    9. Selecionando partes - parte 3
    10. Selecionando partes com query
    11. Agrupamentos
    12. Value_counts
    13. Eliminando dados
    14. Exportando dados
    15. Criando novas colunas
    16. Gráficos com Pandas
    17. Interagindo com planilhas
    18. Reshaping - pivot, stack, unstack
    19. Reshaping - pivot_table
    20. Reshaping - gráficos
    21. Apresentando a base IBM
    22. IBM - info da base
    23. IBM - describe colunas numéricas
    24. IBM - describe colunas não numéricas
    25. IBM - finalizando checagens básicos e proposta de exercícios
    26. IBM - removendo colunas e analisando maiores e menores valores
    27. IBM - introdução a variáveis categóricas
    28. IBM - separando as nossa variáveis
    29. IBM - o tipo categórico do Pandas
    30. IBM - value_counts
    31. IBM - attrition por departamento
    32. IBM - qual coluna utilizar para salário?
    33. IBM - Analisando salário - parte 1
    34. IBM - Analisando salário - parte 2
    35. IBM - Analisando salário - parte 3
    36. IBM - Analisando gênero
    37. IBM - Analisando níveis educacionais
    38. IBM - Histogramas - Idade em cada gênero
    39. IBM - Histogramas - Idade vs attrition
    40. IBM - Lembrando de variáveis categóricas
    41. IBM - A função cut do Pandas
    42. IBM - Histogramas múltiplos
    43. IBM - Boxplots - introdução
    44. IBM - Boxplots - comparação com histograma
    45. IBM - Boxplots - comparando boxplots - parte 1
    46. IBM - Boxplots - comparando boxplots - parte 2
    47. Encerramento do módulo

  • Módulo 5 - Projeto 1 - Analisando o engajamento do Instagram

    1. Explicando o projeto
    2. Importando e tratando a base com Pandas
    3. Tratando valores nulos da coluna Carrossel
    4. Analisando informações estatísticas e as 5 melhores / 5 piores publicações
    5. O group by (groupby) no pandas e a análise do engajamento
    6. Analisando Tags: Separando valores de uma coluna em linhas diferentes (split e explode)
    7. Analisando Tags: Analisando o engajamento por Tags
    8. Analisando Tags: Finalizando a análise da nossa base (analisando tag, pessoas e campanhas)

  • Módulo 6 - Matplotlib e Seaborn

    1. Orientações - Assista antes de começar
    2. Matplotlib - Anatomia de uma figura
    3. Matplotlib - Primeiros exemplos
    4. Matplotlib - Paleta de cores - parte 1
    5. Matplotlib - Paleta de cores - parte 2
    6. Matplotlib - exercícios - gráfico de linhas
    7. Matplotlib - exercícios - gráfico de barras
    8. Matplotlib - exercícios - gráfico de dispersão
    9. Matplotlib - exercícios - gráfico de pizza
    10. Matplotlib - Gráfico de linha para apresentação - parte 1
    11. Matplotlib - Gráfico de linha para apresentação - parte 2
    12. Matplotlib - Gráfico de barras para apresentação - parte 1
    13. Matplotlib - Gráfico de barras para apresentação - parte 2
    14. Matplotlib - Gráfico de barras empilhadas para apresentação
    15. Matplotlib - exercícios - gráfico de barras para apresentação
    16. Matplotlib - exercícios - gráfico de linhas para apresentação
    17. Matplotlib - introdução poo
    18. Matplotlib - poo gráficos simples
    19. Matplotlib - poo mais de um eixo y
    20. Matplotlib - poo múltiplos sistemas de eixo
    21. Matplotlib - poo mosaico
    22. Matplotlib - exercícios
    23. Matplotlib - plt para poo
    24. Matplotlib - criando nosso mosaico
    25. Matplotlib - estilos
    26. Matplotlib - Entendendo a estrutura de um estilo
    27. Matplotlib - Personalizando estilos
    28. Matplotlib - Criando seu próprio estilo
    29. Matplotlib - O Matplotlib por baixo do Pandas
    30. Matplotlib - Pandas para Matplotlib
    31. Matplotlib - Pandas para Matplotlib - parte 2
    32. Matplotlib - Visualizações específicas do Pandas
    33. Matplotlib - Visualizações específicas do Pandas - parte 2
    34. Seaborn - Introdução
    35. Seaborn - temas
    36. Seaborn - pandas
    37. Seaborn - histogramas
    38. Seaborn - KDE
    39. Seaborn - FacetGrid
    40. Seaborn - PairPlot
    41. Seaborn - Boxplot
    42. Seaborn - Categóricas - parte 1
    43. Seaborn - Categóricas - parte 2
    44. Seaborn - Categóricas - parte 3
    45. Seaborn - Correlação - parte 1
    46. Seaborn - Correlação - parte 2

  • Módulo 7 - Introdução a Estatística

    1. Introdução a Estatística e Estatística Descritiva
    2. Tabela de frequência e histograma
    3. Entendendo o conceito da média
    4. Mediana e sua relação com a média
    5. Usando Python para entender a relação entre média e mediana
    6. Média, mediana e moda
    7. Entendendo de forma prática a relação entre média, mediana e moda
    8. QUIZ 5 - Introdução a Estatística

  • Módulo 8 - API - Consumo e Tratamento de Dados de Fontes Externas

    1. O que é uma API?
    2. BrasilAPI - Dados de bancos
    3. BrasilAPI - Tratamento de dados e endpoints
    4. BrasilAPI - Consumo responsável da API
    5. API com dados de países
    6. API com keys
    7. Fred API - paginação
    8. Fred API - criando dataframe
    9. Fred API - Tratamento de dados
    10. Fred API - Gráficos

  • Módulo 9 - Projeto 2 - Criando uma Apresentação Executiva

    1. Apresentando o projeto
    2. Importando e analisando a base
    3. Tratando valores vazios
    4. Usando o datetime para tratar datas
    5. Criando um gráfico de barras no matplotlib
    6. Adicionando título no gráfico e ajustando o eixo x
    7. Adicionando e formatando rótulo de dados, ajustando o eixo y e retirando bordas
    8. Vendas por mês e transformando índices em colunas com o reset_index
    9. Entendendo o deslocamento das barras em um gráfico de barras horizontais
    10. Adicionando todos os anos no gráfico de barras e colocando rótulo nos dados
    11. Mudando os rótulos do eixo x e finalizando o visual da venda por mês
    12. Respondendo qual foi a categoria mais vendida
    13. Criando um gráfico de barras horizontais para o top N itens
    14. Usando o merge para unir 2 bases no pandas
    15. Usando o merge para criar a relação de top N itens pelos anos
    16. Criando o gráfico de barras horizontais do top N itens pelos anos
    17. Concluindo o projeto e respondendo as informações do negócio
    18. Apresentando as informações em um PowerPoint
    19. Corrigindo o erro na transformação da data
    20. (Opcional) Criando um ranking com os produtos que mais aumentaram / caíram as vendas

  • Módulo 10 - Introdução ao Aprendizado de Máquinas

    1. O que é Aprendizado de Máquinas (Machine Learning)?
    2. O aprendizado de máquinas no Instagram
    3. Explicando o Aprendizado de Máquinas
    4. Caso Real: Uso do Aprendizado de Máquinas pelo Walmart
    5. Como funciona um modelo de Aprendizado de Máquinas?
    6. O erro no processo de aprendizado
    7. O Aprendizado de Máquinas no Python
    8. Regressão Linear no Scikit-Learn: importanto, tratando e entendendo os dados
    9. Usando Regressão Linear do Scikit-Learn para calcular a Venda utilizando apenas o Preço
    10. Calculando a regressão linear com Scikit-Learn utilizando Preço Original e Desconto
    11. Usando o sklearn.metrics para calcular os erros de cada um dos modelos
    12. A descrição estatística do Pandas
    13. A variância e o desvio padrão (medidas de dispersão)
    14. Separatrizes: entendendo os quartis

  • Módulo 11 - Como as máquinas aprendem?

    1. Os tipos de aprendizado de máquinas: aprendizado supervisionado e não supervisionado
    2. Os tipos de aprendizado de máquinas: aprendizado semi supervisionado e por reforço
    3. A diferença entre aprender e decorar
    4. Considerações importantes para o Aprendizado de Máquinas

  • Módulo 12 - Projeto 3 - Criando um modelo de classificação

    1. Entendendo e importando o dataset iris do scikit-learn
    2. Tratando os dados do dataset e transformando em um DataFrame do pandas
    3. Escolhendo visualmente quais colunas da base iremos usar no modelo
    4. Criando uma reta capaz de separar os dados do modelo
    5. Classificando um novo ponto usando o modelo visual que acabamos de criar
    6. Criando uma função em Python para classificar um novo ponto no modelo
    7. Entendendo o Perceptron e usando esse algoritmo nos nossos dados
    8. Usando o Perceptron para criar um modelo de aprendizado de máquinas

  • Módulo 13 - Utilizando o Aprendizado de Máquinas

    1. Revisando a importação da base usando o pandas
    2. Revisando a visualização do scatter plot com o matplotlib
    3. Criando uma reta capaz de separar os dados em 2 classes diferentes
    4. (Opcional) Entendendo a reta criada para classificar os pontos
    5. Criando uma função que classfica os dados usando a reta gerada pelo scatter plot
    6. Avaliando um modelo de classificação
    7. A matriz de confusão para um modelo de classificação
    8. Acurácia, precisão e recall em um modelo de classificação
    9. Gerando a matriz de confusão no Scikit-Learn (avaliando modelos de classificação)
    10. Calculando acurácia, precisão e recall no Scikit-Learn (avaliando modelos de classificação)
    11. Avaliando os dados de TREINO do modelo que criamos
    12. Avaliando os dados de TESTE do modelo que criamos
    13. Usando o train_test_split do Scikit-Learn para separar os dados em treino e teste
    14. Usando o train_test_split e avaliando o modelo criado
    15. Explicando o que é uma Árvore de Decisão
    16. Entendendo a classificação dos dados utilizando a Árvore de Decisão
    17. Importando e tratando os dados do projeto 3 (iris) para aplicarmos diferentes modelos de classificação
    18. Separando em treino e teste e analisando os dados de TREINO
    19. Traçando uma reta capaz de separar os dados de TREINO
    20. Criando uma árvore de decisão capaz de separar os dados de TREINO
    21. Avaliando os dados de TESTE para os dois modelos criados

  • Módulo 14 - Análise Exploratória de dados

    1. Explicando a Análise Exploratória e a base que vamos usar (dataset do Titanic)
    2. Importando e entendendo a base do Titanic
    3. Analisando as informações da base e o resumo estatístico
    4. Entendendo a cardinalidade de uma base
    5. Visualizando os dados de forma gráfica
    6. Gerando um boxplot usando o matplotlib
    7. Interpretando o boxplot
    8. Outras opções de gráficos
    9. Correlação entre as variáveis e o KDE (Kernel Density Estimation)
    10. Criando um mapa de calor da correlação entre as variáveis
    11. Tratando valores vazios e outliers
    12. O Pandas Profiling
    13. (Opcional) Corrigindo o erro ao carregar o Pandas Profiling
    14. Apresentando sua análise exploratória de forma executiva

  • Módulo 15 - O Scikit-Learn

    1. Apresentando a documentação do Scikit-Learn
    2. Importando o dataset iris do Scikit-Learn e transformando em um DataFrame do pandas
    3. O Perceptron no Scikit-Learn
    4. Entendendo o resultado gerado pelo perceptron
    5. A árvore de decisão no Scikit-Learn
    6. Classificação no Scikit-Learn: entendendo o dataset e criando os classificadores
    7. Classificação no Scikit-Learn: Avaliando erros de classificação
    8. (Opcional) O average no precision_score
    9. Classificação no Scikit-Learn: separando os dados em treino e teste e avaliando o modelo
    10. Classificação no Scikit-Learn: adicionando novos algoritmos (Regressão Logística) e melhorando o resultado do Perceptron
    11. A equação da reta
    12. Entendendo a regressão linear
    13. O erro na regressão linear
    14. A regressão linear no Scikit-Learn
    15. Regressão no Scikit-Learn: explicando o problema e importando a base
    16. Regressão no Scikit-Learn: utilizando regressão linear simples para prever o volume de ações
    17. Regressão no Scikit-Learn: utilizando regressão linear múltipla
    18. Regressão no Scikit-Learn: tratando a variável de data e utilizando no modelo

  • Módulo 16 - Projeto 4 - Criando um algoritmo de regressão

    1. Explicando o projeto e importando a base de casas da Califórnia
    2. Visualizando os dados de maneira gráfica
    3. Entendendo a base, verificando valores duplicados e tratando outliers
    4. Separando a base em treino e teste e usando Regressão Linear Simples
    5. Utilizando o for para fazer a regressão de todas as colunas da base
    6. Entendendo o coeficiente de determinação (r quadrado)
    7. Métricas de erro para regressão
    8. Avaliando o erro na regressão com Scikit-Learn
    9. Avaliando os erros do nosso modelo e escolhendo o melhor modelo de Regressão Linear Simples
    10. A Regressão Linear Múltipla
    11. Utilizando o for para escolher o melhor par de variáveis na Regressão Linear Múltipla
    12. Utilizando Árvore de Regressão e Support Vector Regression nos dados
    13. Concluindo o projeto e visualizando os resultados de forma gráfica

  • Módulo 17 - Conceitos básicos de SQL para Ciência de Dados

    1. Apresentando o sqlite3
    2. Transformando dados do SQL em um DataFrame do pandas
    3. Selecionando (SELECT) dados de um banco de dados com SQL
    4. Utilizando o WHERE para filtrar a nossa tabela
    5. (Opcional) Revisando o SELECT utilizando o sqlite3
    6. (Opcional) Revisando o SELECT DISTINCT e o WHERE (AND, OR e NOT)
    7. Utilizando o GROUP BY e o ORDER BY no SQL
    8. Limitando a base com o TOP / LIMIT e usando o HAVING para filtrar a tabela
    9. Definindo condicionais no SQL com o CASE
    10. Utilizando subquery no SQL
    11. Outros filtros no SQL (IN e LIKE)
    12. Bases de dados com mais de 1 tabela
    13. Revisando o merge do pandas
    14. Unindo duas bases no SQL utilizando o JOIN
    15. O UNION e o FULL JOIN no SQL

  • Módulo 18 - Técnicas de storytelling com dados: Utilizando o SQL com dados reais de venda

    1. Apresentando a base de dados que vamos utilizar nesse módulo
    2. Usando a biblioteca os para buscar os arquivos da nossa base de dados
    3. Importando todas as bases de dados para o pandas
    4. Analisando a base de ordens, itens e pagamentos para iniciar o entendimento dos dados
    5. Utilizando o groupby do pandas para analisar as ordens com mais de 1 item
    6. Fazendo o pivot (pivotando) da tabela para analisar diferentes itens na mesma ordem
    7. Finalizando o entendimento da base analisando pagamentos, vendedores e review
    8. (Opcional) Criando um banco de dados utilizando a documentação do sqlite3
    9. (Opcional) Criando uma tabela utilizando um DataFrame do pandas
    10. (Opcional) Inserindo dados em uma tabela utilizando o to_sql e o INSERT
    11. (Opcional) Atualizando e deletando registros em uma tabela utilizando UPDATE e DELETE
    12. Usando a biblioteca os para visualizar os arquivos que iremos transformar em tabelas
    13. Criando um banco de dados e a nossa primeira tabela
    14. Adicionando todos os arquivos da pasta como tabelas no banco de dados
    15. Ajustando as colunas de datas e usando o if_exists para substituir tabelas em uma banco
    16. Criando uma função para automatizar as consultas no nosso banco de dados
    17. Apresentando o banco de dados de vendas
    18. Exercício: Melhorando a satisfação do cliente
    19. Criando uma história com seus dados
    20. Dicas para uma boa apresentação de dados
    21. A estrutura de uma história
    22. Resolução - O problema realmente existe? Conectando ao banco e começando a analisar a tabela de pedidos
    23. Resolução - Tratando as colunas de data que estão como texto (usando o to_datetime do pandas)
    24. Resolução - Calculando o atraso na entrega e verificando a média de atraso utilizando o datetime
    25. Resolução - Utilizando o to_period para calcular a média do atraso em cada um dos meses
    26. Resolução - Analisando o máximo e mínimo do atraso e visualizando graficamente utilizando o matplotlib
    27. Resolução - Criando uma função para contar o número de pedidos atrasados (usando apply e lambda function)
    28. (Opcional) Formatando o gráfico de pedidos atrasados no matplotlib
    29. Resolução - Relação da avaliação com o atraso (Analisando a tabela de avaliações e a tabela de pedidos)
    30. Resolução - Entendendo a relação entre a tabela de pedidos e a de avaliações (pedidos sem avaliação e pedidos com mais de uma avaliação)
    31. Resolução - Avaliando a média e o máximo das notas para pedidos com mais de uma avaliação
    32. Resolução - Finalizando o tratamento da base e analisando o impacto de utilizar o máximo ao invés da média das notas para pedidos com mais de uma avaliação
    33. Resolução - Entendendo a relação entre o atraso e a avaliação dos clientes
    34. Resolução - Calculando a média da avaliação por cada período de atraso e apresentando graficamente essa informação
    35. (Opcional) Formatando o gráfico de atraso no pedido x avaliação
    36. Resolução - Avaliando os comentários de pedidos atrasados
    37. Resolução - Usando o wordcloud para verificar as palavras mais frequentes nas reclamações
    38. Resolução - Melhorando a núvem de palavras (wordcloud) e criando uma núvem de frases
    39. Criando uma história com os dados gerados na nossa análise

  • Módulo 19 - Projeto 5 - Criando um modelo de identificação de fraude

    1. Mostrando a base desse módulo e apresentando o Kaggle e a sua importância para nossos projetos de ciência de dados
    2. Entendendo a base de transações e analisando a relação entre fraude e não fraude
    3. Criando um modelo de classificação de fraude usando a base desbalanceada e analisando a acurácia, precisão e recall desse modelo
    4. Apresentando o imbalanced-learn e utilizando o undersampling e o oversampling para os nossos dados de crédito
    5. (Opcional) Importando e visualizando a base de transações
    6. Revisando o undersampling e o oversampling do imbalanced-learn e visualizando de forma gráfica as novas bases geradas
    7. Explicando o RandomUnderSampler do imblearn
    8. Apresentando de forma visual o funcionamento do RandomUnderSampling
    9. Utilizando o ClusterCentroids e o NearMiss para realizar o undersampling
    10. Explicando o RandomOverSampler do imblearn
    11. Usando o shrinkage do RandomOverSampler e visualizando graficamente os novos dados
    12. Utilizando SMOTE e ADASYM para realizar o oversampling
    13. Realizando o undersampling com o RandomUnderSampler na base de transações e analisando a acurácia e o recall
    14. Fazendo o oversampling com o RandomOverSampler para essa mesma base e comparando os resultados
    15. Utilizando o ClusterCentroids e o NearMiss para o undersampling para o modelo de classificação de fraude
    16. Utilizando SMOTE e ADASYM para o oversampling e testando combinar os métodos para o modelo de classificação de fraude
    17. Revisando as métricas de avaliação para modelos de classificação
    18. Explicando a curva ROC
    19. Traçando a curva ROC utilizando a árvore de decisão para um classificador perfeito
    20. Comparando a curva ROC da árvore de decisão com a da regressão logísitca
    21. Explicando a curva de precisão x recall
    22. (Opcional) Visualizando graficamente como as curvas ROC e precisão x recall são geradas
    23. Criando diferentes modelos para classificar nossos pontos (Regressão Logística, KNN, SVM, Random Forest)
    24. Usando a área abaixo da curva de precisão x recall e comparando os diferentes modelos
    25. Melhorando a escala dos dados e selecionando os melhores modelos para classificar os dados
    26. Selecionando os melhores hiperparâmetros para o modelo de Regressão Logística
    27. (Opcional) Criando manualmente um código para testar diferentes hiperparâmetros no modelo
    28. Usando o GridSearchCV para selecionar os melhores hiperparâmetros para a Regressão Logística
    29. Usando o GridSearchCV para o Support Vector Classifier (SVC / SVM)
    30. Usando o GridSearchCV para o Random Forest
    31. (Opcional) Usando o GridSearchCV para o KNN
    32. (Opcional) Revisando tudo que fizemos até agora
    33. Testando novas melhorias no modelo: Adicionando novos parâmetros no GridSearchCV da Regressão Logística
    34. Testando novas melhorias no modelo: Testando outras formas de realizar o undersampling
    35. Testando novas melhorias no modelo: Mudando o scoring do GridSearchCV e discutindo sobre o oversampling

  • Módulo 20 - Subindo seu modelo para produção (Deploy)

    1. Criando um modelo de Regressão Linear passo a passo
    2. Persistindo o modelo (usando o dump e load do joblib)
    3. (Opcional) Utilizando o modelo nos mesmos dados para provar que temos exatamente o mesmo modelo
    4. Utilizando o modelo criado em dados de produção
    5. Colocando nosso modelo em produção utilizando um arquivo do Jupyter Notebook
    6. Utilizando um arquivo .py para colocar o modelo em produção
    7. Criando um executável para realizar a previsão utilizando o modelo criado
    8. Apresentando o Streamlit para criarmos uma tela para o usuário acessar o modelo
    9. Criando campos de entrada para os valores numéricos de preço e desconto e o botão de "PREVER""
    10. Criando uma tela para o usuário utilizar o nosso modelo com o Streamlit
    11. (Opcional) Explicando o predict

  • Módulo 21 - Ajustando os dados para o modelo (Data Cleaning)

    1. Explicando a importância da limpeza dos dados e importando a base
    2. Buscando na base por valores nulos e linhas duplicadas
    3. Procurando na base alguns problemas que podem ter sido gerados por erros humanos
    4. Tratando valores vazios e linhas duplicadas
    5. Tratando valores digitados errados (erros humanos)
    6. Limpeza de Dados - Exercício
    7. Entendendo a base e respondendo as perguntas sem fazer o tratamento dos dados
    8. Contando a quantidade de alunos que responderam o questionário
    9. Eliminando valores duplicados e discutindo sobre o tratamento do ID_aluno
    10. Somando a matrícula dos alunos que responderam (visualizando e tratando outliers)
    11. Verificando o tamanho da blusa para todos os alunos
    12. Descobrindo quantos alunos vão participar da formatura
    13. Estimando a altura de um aluno usando média e mediana dos dados
    14. Aprofundando no tratamento de dados: Entendendo a base de notas de português
    15. Usando o drop_duplicates para retirar valores duplicados da base
    16. Analisando o describe e o boxplot e tratando outliers nos dados
    17. Criando a função para transformar as notas dadas em conceitos (textos) em números de 1 a 10
    18. Otimizando a função criada, unindo duas bases e calculando a média final dos alunos
    19. Apresentando a base de cadastro dos alunos e tratando e-mails escritos errados
    20. Tratando a data e ajustando as colunas de texto no cadastro dos alunos
    21. Exercício: limpeza dos dados no dataset do titanic
    22. Tratando as informações de embarque vazias e usando a mediana para as idades
    23. Analisando a média das idades pela classe, gênero e pelo título extraído do nome
    24. Usando o transform para substituir as idades vazias pelo resultado do groupby e eliminando colunas desnecessárias
    25. Analisando outliers, cardinalidade e eliminando colunas desnecessárias

  • Módulo 22 - Outros modelos supervisionados

    1. Relembrando o Perceptron e importando o dataset iris
    2. Criando um modelo utilizando o perceptron
    3. Utilizando o coef_ e o intercept_ para traçar a reta gerada pelo perceptron
    4. Explicando o Perceptron para mais de 2 classes e para dados que não são linearmente separáveis
    5. Relembrando a árvore de decisão e aprofundando teoricamente
    6. Importando novamente o dataset iris e criando um modelo utilizando a árvore de classificação
    7. Visualizando graficamente como funciona uma árvore de decisão
    8. Fazendo a previsão utilizando o predict e as regiões gráficas que criamos
    9. Utilizando todo o dataset iris para criar nossa árvore de decisão
    10. Explicando o índice gini e a entropia utilizados no "criterion"
    11. (Opcional) Visualizando graficamente o índice gini e a entropia
    12. O tamanho da árvore: utilizando o max_depth para melhorar a acurácia do modelo
    13. Relembrando a regressão linear
    14. Visualizando graficamente a vantagem da regressão linear ao criar a melhor reta (menor erro quadrático)
    15. Utilizando a regressão linear de forma prática no dataset de casas da Califórnia
    16. Apresentando os conceitos do K-Nearest Neighbors (KNN)
    17. Utilizando o KNN e entendendo o cálculo da distância entre os pontos (euclidiana e manhattan)
    18. Calculando manualmente as distâncias euclidiana e manhattan do ponto central
    19. Utilizando o kneighbors para visualizar os pontos mais próximos e mudando a ordem dos dados para avaliar a previsão
    20. Utilizando o KNN com um dataset real (dataset iris) e avaliando a previsão desse algoritmo
    21. Entendendo visualmente a previsão feita para o dataset iris
    22. Apresentando a Regressão Logística e importando o dataset iris
    23. Utilizando a regressão logística e visualizando graficamente o gráfico gerado
    24. Entendendo o predict_proba (prevendo a probabilidade de cada uma das classes)
    25. Utilizando a regressão logística para um problema com 3 classes
    26. Utilizando todo o dataset iris para criar a regressão logística
    27. Apresentando o Support Vector Machine (SVM)
    28. (Opcional) Importando novamente o dataset iris (passo a passo)
    29. Utilizando o SVM (SCV) e visualizando graficamente o resultado em dados linearmente separáveis
    30. Explicando o hiperparâmetro C e as margens rígidas e flexíveis do SVM
    31. Utilizando o SVM para dados que não são linearmente separáveis e analisando o dataset iris completo

  • Módulo 23 - O Aprendizado Não Supervisionado

    1. Revisando os tipos de aprendizado e relembrando o aprendizado não supervisionado
    2. Apresentando os principais conceitos da aprendizagem não supervisionada
    3. Explicando o K-means para clusterização / agrupamento dos dados
    4. Detalhando o K-means e explicando o hiperparâmetro init e o Elbow Method (método do cotovelo)
    5. Importando o dataset iris e utilizando o K-means para criar 2 clusters nesses dados
    6. Entendendo matematicamente a classificação dos pontos em cada um dos clusters / grupos
    7. (Opcional) Entendendo a distância euclidiana
    8. Visualizando os clusters / grupos para diferentes valores de K e utilizando o Elbow Method (Método do Cotovelo) para a escolha de K
    9. Comparando os clusters gerados com as classes do dataset iris para valores de k próximos ao número de classes
    10. Exercício: utilizando o K-Means para agrupar os valores do dataset load_digits
    11. Entendendo a base e utilizando a documentação para importar o K-Means
    12. Utilizando o Elbow Method (método do cotovelo) para escolher um valor de K para iniciarmos nossa análise
    13. Utilizando K = 9 e transformando os números do label em letras para analisarmos os grupos
    14. Visualizando a tabela relacionando os rótulos (targets) reais dos dados com os grupos gerados pelo K-Means
    15. Entendendo os dígitos classificados errados e discutindo como essa avaliação poderia ser feito sem os rótulos (targets) dos dados
    16. Usando os grupos para classificar os dados e avaliando os erros dessa classificação
    17. Testando diferentes valores de k e buscando a melhor clusterização para os dados
    18. Métricas de avaliação no aprendizado não supervisionado
    19. (Opcional) Clusterizando o dataset iris e analisando a relação entre target (rótulo) e os labels do kmeans
    20. (Opcional) Utilizando a classe mais frequente no cluster para fazer a previsão dos dados (criando um y_pred como na classificação)
    21. (Opcional) Avaliando a clusterização utilizando as métricas de classificação (matriz de confusão, acurácia, precisão e recall)
    22. Explicando a base teórica do Rand Index e usando essa métrica para avaliar a clusterização
    23. Apresentando o ajuste do Rand Index (Adjusted Rand Index) e comparando as duas métricas
    24. Utilizando o Rand Index (e o índice ajustado) no dataset iris e avaliando diferentes valores de k
    25. Apresentando a médida V (V Measure), a homogeneidade e a completude
    26. Usando a medida V, homogeneidade e completude para avaliar o dataset iris
    27. Revisando a inércia e apresentando os conceitos do "Coeficiente Silhueta" (silhouette_score)
    28. Apresentando matematicamente o cálculo do coeficiente silhueta para um ponto de dado (silhouette_samples)
    29. Calculando o silhouette_score para os dados e entendendo os principais conceitos dessa métrica
    30. Criando um plot para visualiar o silhoutte_score, o silhoutte_simples e os clusters dos dados (Parte 1)
    31. Criando um plot para visualiar o silhoutte_score, o silhoutte_simples e os clusters dos dados (Parte 2)
    32. Criando uma visualização considerando o silhoutte_score e os clusters dos dados para o dataset iris
    33. Apresentando o PCA (Principal Component Analysis)
    34. (Opcional) Passo a passo para a definição dos componentes principais do PCA
    35. Utilizando o PCA nos dados e entendendo os principais parâmetros e atributos da documentação (Parte 1)
    36. Utilizando o PCA nos dados e entendendo os principais parâmetros e atributos da documentação (Parte 2)
    37. Reduzindo o dataset de 3 dimensões para 2 utilizando o PCA e utilizando o PCA no dataset iris
    38. A ciência além dos dados: ética em Data Science
    39. Livro: Algoritmos de destruição em massa (exemplos práticos)
    40. Cuidados importantes para garantirmos a ética em nossos projetos de Data Science

  • Módulo 24 - Feature engineering

    1. O que é Feature Engineering?
    2. Utilizando lambda function para transformar uma coluna de texto em uma nova coluna de valores 1 ou 0
    3. O OneHotEncoder para tratamento de colunas com texto
    4. Unindo nosso dataset com os dados gerados pelo OneHotEncoder e fazendo o Encoding para todas as colunas de texto
    5. Fazendo o One Hot Encoding utilizando o get_dummies do pandas
    6. Utilizando o max_categories e o min_frequency do OneHotEncoder para limitar o número de colunas geradas
    7. Alertando sobre o cuidado ao usar o get_dummies quando a coluna pode receber diferentes valores em produção
    8. Utilizando o handle_unknown do OneHotEncoder para tratar categorias desconhecidas nos dados de produção
    9. Apresentando o OrdinalEncoder para colunas com texto que possuem relação entre os rótulos
    10. Definindo a ordem das categorias e tratando valores desconhecidos (categories, handle_unknown e unknown_value no OrdinalEncoder)
    11. Escolhendo o tipo de dado (dtype) no OrdinalEncoder e fazendo o encoding para mais de uma coluna
    12. Tratando features com diferença de escala (padronização e normalização)
    13. Utilizando a padronização (escala padrão) na coluna Age do dataset Titanic
    14. Utilizando a normalização com o MinMaxScaler nessa mesma coluna
    15. Apresentando o MaxAbsScaler para dados esparsos (dispersos) e o RobustScaler para dados com outliers
    16. Apresentando visualmente a diferença entre a escala padrão, o MinMax, o MaxAbs e o RobustScaler
    17. Realizando o cálculo matemático passo a passo de cada uma das transformações vistas até agora (Standard, MinMax, MaxAbs e Robust)
    18. Fazendo a padronização e normalização dos dados da coluna Fare
    19. (Opcional) Visualizando o histograma de cada transformação e comparando entre eles
    20. Utilizando o Normalizer para fazer a normalização das linhas de um dataset
    21. Transformando valores contínuos em atributos discretos com a Discretização
    22. Dividindo o intervalo em grupos com o mesmo comprimento utilizando o KBinsDiscretizer com "strategy=uniform"
    23. Utilizando o quantile do KBinsDiscretizer para gerar "grupos" com uma quantidade próxima de dados
    24. Binarizando os dados utilizando um limite através do Binarizer
    25. Explicando a Seleção de Recursos (Feature Selection) e removendo features com baixa variância (VarianceThreshold)
    26. Utilizando o VarianceThreshold para eliminar colunas com muitos valores repetidos
    27. Utilizando o SelectKBest para a Seleção Univariada de Recursos
    28. Selecionando os melhores recursos (features) utilizando o SelectKBest para classificação e regressão
    29. Utilizando o SelectKBest em um dataset real (de fraudes de cartão de crédito)
    30. Escolhendo o melhor valor de K para o SelectKBest
    31. Utilizando o Recursive Feature Elimination (RFE) para a seleção das variáveis

  • Módulo 25 - [R] R Básico

    1. Primeiros passos em R: Apresentando e instalando o R e o RStudio
    2. Visão geral do RStudio (entendendo a IDE) e importando / salvando arquivos
    3. Escrevendo comentários e imprimindo valores na tela (print)
    4. Criando variáveis em R
    5. Operações matemáticas básicas em R
    6. Operações lógicas e de comparação em R
    7. Tipos e estruturas de dados
    8. Vetores
    9. Matrizes - Parte 1
    10. Matrizes - Parte 2
    11. DataFrames
    12. Programação em R
    13. Entrada e saída de dados
    14. Manipulação de dados com dplyr - Parte 1
    15. Manipulação de dados com dplyr - Parte 2
    16. Tratamento de dados com tidyr
    17. Visualização de dados com ggplot - Parte 1
    18. Visualização de dados com ggplot - Parte 2

  • Módulo 26 - Projeto em R

    1. Importando os datasets e começando a limpeza dos dados (tratando valores vazios)
    2. Tratando colunas de texto com valores vazios e finalizando o tratamento da base de teste
    3. Criando visualizações gráficas com o ggplot
    4. Separando os dados em treino e teste e usando a árvore de decisão para criar o primeiro modelo
    5. Criando novos modelos utilizando Regressão Logística e o KNN (k nearest neighbors)
    6. Usando o melhor modelo nos dados de teste e fazendo a submissão na competição do Kaggle

  • Módulo 27 - Criando seu portifólio

    1. Criando seu portfólio e datasets (bases de dados) para seus primeiros passos
    2. Utilizando datasets mais simples para criar seu portfólio
    3. Datasets mais complexos (e completos) para o seu portfólio
    4. Começando o seu portfólio e criando o seu LinkedIn
    5. Tornando o seu perfil do LinkedIn relevante para recrutadores
    6. Criando um LinkedIn do zero
    7. Criando seu perfil do GitHub (e o arquivo README)
    8. Criando um GitHub do zero
    9. Introdução ao markdown e HTML (para seu README do GitHub)
    10. Cabeçalhos, imagens e links no HTML
    11. Divisões, comentários, enter e espaço no HTML
    12. Conceitos importantes de markdown para o seu README do GitHub
    13. Começando a criar seu README do GitHub (título, descrição, ícones, links e textos em destaque)
    14. Adicionando ícones, redes sociais e artigos / conteúdos no seu README do GitHub
    15. Criando seus artigos no Medium / LinkedIn
    16. Criando seus artigos do zero
    17. O que é SEO e utilizando o Google Trends para escolher o melhor título para o seu artigo
    18. Otimizando cabeçalhos, URLs e links para o SEO
    19. Palavras-chave (pesquisa Google / Google Trends) e imagens para o SEO
    20. Aplicando os conceitos do SEO de forma prática

  • Módulo 28 - Projeto Completo

    1. Apresentando o projeto desse módulo: House Prices do Kaggle
    2. Entendendo a base do desafio e tratando colunas com muitos valores vazios
    3. Tratando valores vazios e selecionando apenas as colunas numéricas
    4. Criando e avaliando diferentes modelos nesses dados (Regressão Linear, Árvore de Regressão e KNN)
    5. (Opcional) Apresentando visualmente a relação entre os dados reais (y_test) e a previsão feita nos 3 modelos (y_pred)
    6. Fazendo a previsão nos dados de treino e submetendo nosso modelo para avaliação do Kaggle
    7. Usando o github para apresentar esse projeto para os recrutadores
    8. Começando a limpeza dos dados (data cleaning) da base (tratando colunas com muitos valores vazios)
    9. Melhorando o visual do gráfico e fazendo o tratamento para a base de teste
    10. Tratando a coluna FireplaceQu e usando a média dos valores (transform) para tratar a coluna LotConfig
    11. Analisando e tratando as colunas de Garagem para a base de treino
    12. Utilizando colunas com alta correlação para substituir valores vazios em GarageYrBlt
    13. Usando a moda e média das variáveis para substituir valores vazios nas colunas de Garagem
    14. Tratando as colunas de porão para a base de treino
    15. Analisando e tratando a coluna BsmtQual para a base de teste
    16. Finalizando o tratamento das colunas de porão para a base de teste
    17. Tratando o restante das colunas vazias da base de treino (MasVnrType, MasVnrArea, Electrical)
    18. Tratando o restante das colunas vazias da base de teste (MSZoning, Functional, Utilities,...)
    19. Executando o modelo após a limpeza dos dados
    20. Começando a Análise Exploratória dos Dados e entendendo as correlações entre as colunas numéricas
    21. Analisando as colunas de texto e buscando os valores mais frequentes em casas caras e baratas
    22. Criando funções (lambda function e utilizando o def) para tratar as colunas CentralAir e PavedDrive
    23. Utilizando o OneHotEncoder para tratar a coluna MSZoning
    24. Eliminando as colunas desnecessárias de Garagem (GarageCond, GarageArea e GarageYrBlt) -> LER DESCRIÇÃO
    25. Utilizando o OneHotEncoder para tratar a coluna GarageType e o OrdinalEncoder para tratas as colunas GarageQual e GarageFinish
    26. Executando o modelo após o tratamento inicial das colunas de texto (parte 1)
    27. Finalizando o tratamento de todas as outras colunas que ainda estão como texto (parte 1)
    28. Finalizando o tratamento de todas as outras colunas que ainda estão como texto (parte 2)
    29. Executando o modelo após o tratamento completo das colunas de texto (parte 2)
    30. Organizando o github com os resultados do projeto
    31. Adicionando novos algoritmos: RandomForest e XGBoost na primeira base de dados
    32. Utilizando os novos algoritmos (RandomForest e XGBoost) na base de dados com todas as colunas / variáveis
    33. Usando o grid_search para encontrar os melhores parâmetros para o modelo

  • Módulo 29 - Seleção de modelos

    1. Introdução
    2. Critérios - Complexidade e interpretabilidade
    3. Critérios - Eficiência computacional - 01 - Entendendo o dataset
    4. Critérios - Eficiência computacional - 02 - Variáveis
    5. Critérios - Eficiência computacional - 03 - Loop for - parte 1
    6. Critérios - Eficiência computacional - 04 - Loop for - parte 2
    7. Critérios - Eficiência computacional - 05 - Analisando os resultados
    8. Critérios - Sensibilidade à escala dos dados - 01 - Describe do dataset
    9. Sensibilidade à escala dos dados - 02 - Gráficos para cada variável
    10. Critérios - Sensibilidade à escala dos dados - 03 - Selecionando um Scaler
    11. Critérios - Sensibilidade à escala dos dados - 04 - Analisando os resultados
    12. Critérios - Habilidade de generalização
    13. Pipelines - 01 - Introdução
    14. Pipelines - 02 - Trabalhando sem pipeline
    15. Pipelines - 03 - Pipeline e make_pipeline
    16. Pipelines - 04 - Função para o pipeline
    17. Pipelines - 05 - Analisando os resultados
    18. Pipelines - 06 - Adicionando transformações em colunas
    19. Validação cruzada - 01 - Introdução
    20. Validação cruzada - 02 - KFold e cross_validate
    21. Validação cruzada - 03 - Problema do KFold com desbalanceamento
    22. Validação cruzada - 04 - StratifiedKFold
    23. Validação cruzada - 05 - Função com pipeline e cross_validate
    24. Validação cruzada - 06 - Dataframe com os resultados
    25. Validação cruzada - 07 - Gráficos para os resultados
    26. Validação cruzada - 08 - Resolvendo qual modelo utilizar
    27. Otimização de hiperparâmetros - 01 - Analisando os hiperparâmetros
    28. Otimização de hiperparâmetros - 02 - Estruturando o GridSearch
    29. Otimização de hiperparâmetros - 03 - Analisando os resultados

  • Módulo 30 - Projeto - Segmentação de clientes

    1. Apresentação e organização do projeto
    2. Versões das bibliotecas do projeto
    3. Describe da base de dados
    4. EDA - Criando o ProfileReport
    5. EDA - Analisando o ProfileReport
    6. EDA - Analisando outliers e correlação
    7. EDA - Pairplots
    8. Análise sem pré-processamento - Introdução
    9. Análise sem pré-processamento - Definindo número de clusters
    10. Análise sem pré-processamento - Treinando o modelo
    11. Análise sem pré-processamento - Perfis
    12. Análise sem pré-processamento - Obtendo os valores de centroides
    13. Análise sem pré-processamento - Gráfico com centroides
    14. Análise sem pré-processamento - Função para o gráfico
    15. Pré-processamento
    16. Definindo o número de clusters
    17. Pipeline e treinamento
    18. Gráficos
    19. Preparando os dados para visualização
    20. Visualizando os clusters
    21. Pipeline com PCA
    22. Visualizações
    23. Ajustes finais para publicação do projeto
    24. Projeto no GitHub

  • Módulo 31 - Projeto - Clusterização - Analista de dados do iFood

    1. Visão geral do projeto
    2. Detalhes do case do projeto - parte 1
    3. Detalhes do case do projeto - parte 2
    4. Conhecendo a base de dados
    5. Análise crítica de alguns aspectos
    6. Profile Report - parte 1
    7. Profile Report - parte 2
    8. Novas colunas - parte 1
    9. Novas colunas - parte 2
    10. Novas colunas - parte 3
    11. Novas colunas - parte 4
    12. Novas colunas - parte 5
    13. Novas colunas - parte 6
    14. Outliers - boxplots
    15. Outliers - criando uma função de inspeção
    16. Outliers - tomando decisões
    17. Outliers - eliminando colunas
    18. Selecionando colunas para análise
    19. Visualizando os dados - parte 1
    20. Visualizando os dados - parte 2
    21. Visualizando os dados - parte 3
    22. Visualizando os dados - parte 4
    23. Visualizando os dados - parte 5
    24. Correlações - parte 1
    25. Correlações - parte 2
    26. Correlações - parte 3
    27. Gráfico de correlações
    28. Ajustes e primeira revisão
    29. Analisando os perfis das colunas para escolha das transformações - parte 1
    30. Analisando os perfis das colunas para escolha das transformações - parte 2
    31. Pré-processamento
    32. Definindo a quantidade de clusters
    33. Características de cada cluster - parte 1
    34. Características de cada cluster - parte 2
    35. Características de cada cluster - parte 3
    36. Características de cada cluster - parte 4
    37. Características de cada cluster - parte 5
    38. Características de cada cluster - parte 6
    39. Características de cada cluster - parte 7
    40. Características de cada cluster - parte 8
    41. Características de cada cluster - parte 9
    42. Ajustes e segunda revisão
    43. PCA - parte 1
    44. PCA - parte 2
    45. Escolhendo modelos de classificação
    46. Pipeline
    47. Resolvendo qual o melhor modelo para continuar o projeto
    48. Regressão logística
    49. Estruturando o GridSearchCV
    50. Entendendo os resultados do GridSearchCV
    51. Criando um pipeline com o modelo otimizado
    52. Descobrindo as features mais importantes
    53. Finalizando e revisando a análise do modelo de classificação
    54. Finalizando o projeto e colocando no GitHub. Revisão final

  • Módulo 32 - Introdução ao Deep Learning

    1. O que é Deep Learning
    2. Aplicações de Deep Learning
    3. Histórico e por onde começar
    4. Relembrando perceptrons
    5. Explorando o objeto perceptron
    6. Visualizando os valores do somatório
    7. Função de ativação sigmoid
    8. Introdução a funções de custo
    9. Função de custo log-loss
    10. Traçando outras retas
    11. Gradient descent - conceito fundamental
    12. Gradient descent - entendendo o algoritmo
    13. Gradient descent - taxa de aprendizagem
    14. Gradient descent - busca pelo mínimo global
    15. SGD - stochastic gradient descent
    16. Verificando a melhora de log-loss
    17. SGD - Detalhando o modelo
    18. SGD - Visualizando as etapas do modelo

  • Módulo 33 - Introdução ao Tensorflow

    1. Scikit-Learn vs Tensorflow
    2. O Tensor e o Flow
    3. Tensores com NumPy
    4. Exemplo de aplicação de tensor com NumPy
    5. Instalando o TensorFlow sem e com GPU
    6. Tensores com TensorFlow
    7. Tensores com TensorFlow
    8. Tensores de rank 4 - conceito de batch
    9. Operações com tensores
    10. Funções que atuam em tensores
    11. Outras funções de ativação - Introdução
    12. Outras funções de ativação - Camadas ocultas
    13. Outras funções de ativação - Camadas de saída
    14. Tensores esparsos - conceito
    15. Tensores esparsos vs one-hot encode
    16. Tensores esparsos - Problemas de classificação

  • Módulo 34 - Primeiras Redes Neurais

    1. Introdução ao Keras
    2. Entendendo os dados
    3. Definindo o modelo - parte 1
    4. Definindo o modelo - parte 2
    5. Compilando o modelo
    6. Fit do modelo - parte 1
    7. Fit do modelo - parte 2
    8. Fit do modelo - parte 3
    9. Evaluate do modelo
    10. Predict do modelo
    11. Visualizando o resultado
    12. Segunda rede neural - mantendo o modelo anterior
    13. Segunda rede neural - melhorando o modelo
    14. Terceira rede neural - mantendo o modelo anterior
    15. Terceira rede neural - melhorando o modelo
    16. Terceira rede neural - melhorando o modelo - parte 2

  • Módulo 35 - Projeto MNIST

    1. Sobre a base MNIST
    2. Primeiras ideias de modelo
    3. Carregando os dados - parte 1
    4. Carregando os dados - parte 2
    5. Carregando os dados - parte 3
    6. Definindo o primeiro modelo
    7. Compilando o primeiro modelo
    8. Fit do primeiro modelo
    9. Evaluate do primeiro modelo
    10. Predict do primeiro modelo - parte 1
    11. Predict do primeiro modelo - parte 2
    12. Predict do primeiro modelo - parte 3
    13. Predict do primeiro modelo - parte 4
    14. Predict do primeiro modelo - parte 5
    15. Segundo modelo
    16. CNNs
    17. CNNs - principais parâmetros
    18. CNNs - Exemplo - parte 1
    19. CNNs - Exemplo - parte 2
    20. CNNs - Pooling
    21. CNNs - Average pooling
    22. CNNs - Max pooling
    23. CNNs - primeiro modelo
    24. CNNs - segundo modelo
    25. CNNs - terceiro modelo - data augmentation - parte 1
    26. CNNs - terceiro modelo - data augmentation - parte 2
    27. Keras Tuner - parte 1
    28. Keras Tuner - parte 2
    29. Keras Tuner - parte 3
    30. Keras Tuner - parte 4
    31. Salvando um modelo
    32. Reprodutibilidade e random seed
    33. Dicas para colocar o projeto no portfolio

  • Módulo 36 - Projeto CIFAR

    1. Sobre a base CIFAR-10
    2. Estrutura inicial do projeto
    3. Carregando os dados - parte 1
    4. Carregando os dados - parte 2
    5. Definindo o modelo Keras
    6. Compile e fit
    7. Evaluate e predict - parte 1
    8. Predict - parte 2
    9. Predict - parte 3
    10. Predict - parte 4
    11. Predict - parte 5
    12. Segundo modelo - Dropouts
    13. Terceiro modelo - padding
    14. Quarto modelo - data augmentation
    15. Introdução ao VGG - parte 1
    16. Introdução ao VGG - parte 2
    17. Quinto modelo - VGG simplificado
    18. Sexto modelo - VGG
    19. Transferência de aprendizado - parte 1
    20. Transferência de aprendizado - parte 2
    21. Transferência de aprendizado - parte 3
    22. Sétimo modelo - VGG19 - parte 1
    23. Sétimo modelo - VGG19 - parte 2
    24. Sétimo modelo - VGG19 - parte 3
    25. Melhorando o código
    26. Google Colab
    27. Oitavo modelo - VGG19 - upsampling
    28. Oitavo modelo - VGG19 - resultados
    29. Lidando com esgotamento de recursos
    30. Oitavo modelo - VGG19 - carregando o modelo e detalhando os resultados - parte 1
    31. Oitavo modelo - VGG19 - carregando o modelo e detalhando os resultados - parte 2
    32. Oitavo modelo - VGG19 - carregando o modelo e detalhando os resultados - parte 3
    33. Introdução ao ResNet
    34. Nono modelo - ResNet50
    35. Décimo modelo - ResNet50 - upsampling - parte 1
    36. Décimo modelo - ResNet50 - upsampling - parte 2
    37. Finalizando o projeto e orientações

  • Módulo 37 - Projeto AutoMPG

    1. Sobre a base Auto MPG
    2. Estrutura do projeto
    3. Carregando os dados.
    4. Profile Report
    5. Transformando os dados - parte 1
    6. Transformando os dados - parte 2
    7. Pairplot
    8. Boxplots
    9. Tratando valores nulos
    10. Separando os dados em treino e teste
    11. Primeiro modelo - Definindo modelo de regressão simples
    12. Primeiro modelo - Compilando
    13. Primeiro modelo - Fit
    14. Primeiro modelo - Evaluate e predict - parte 1
    15. Primeiro modelo - Predict - parte 2
    16. Segundo modelo - Camadas ocultas
    17. Terceiro Modelo
    18. Finalizando o projeto e orientações para portfolio

  • Módulo 38 - Projeto IMBD

    1. Sobre a base e a estrutura do projeto
    2. Carregando os dados
    3. Conceito de token
    4. Trabalhando o índice de palavras
    5. Limitando o número de tokens de cada review
    6. Conceito de embeddings
    7. Definindo o modelo
    8. Compile, fit e evaluate do modelo
    9. Predict - parte 1
    10. Predict - parte 2
    11. Predict - parte 3
    12. Segundo modelo
    13. Terceiro modelo
    14. Finalizando o projeto e orientações para portfolio

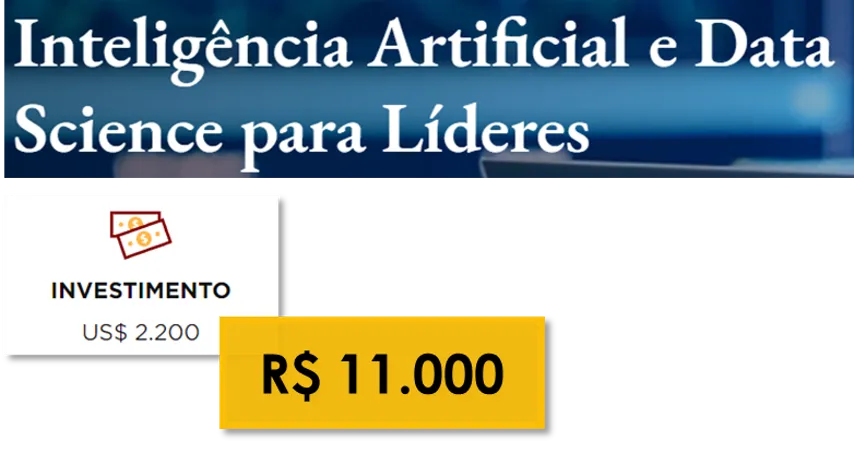
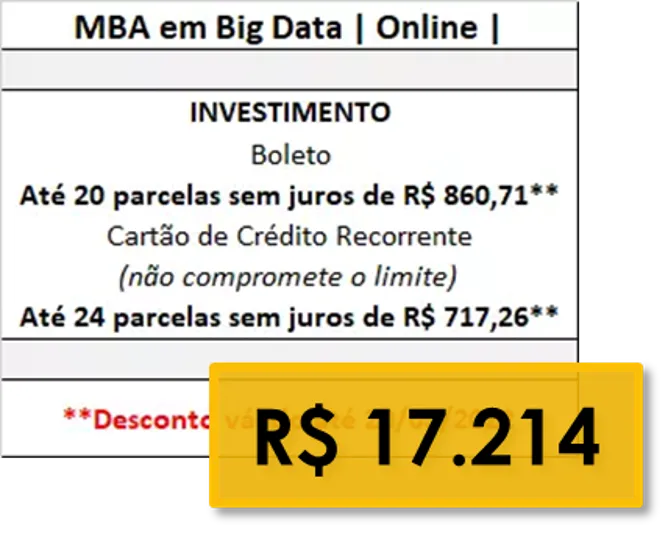
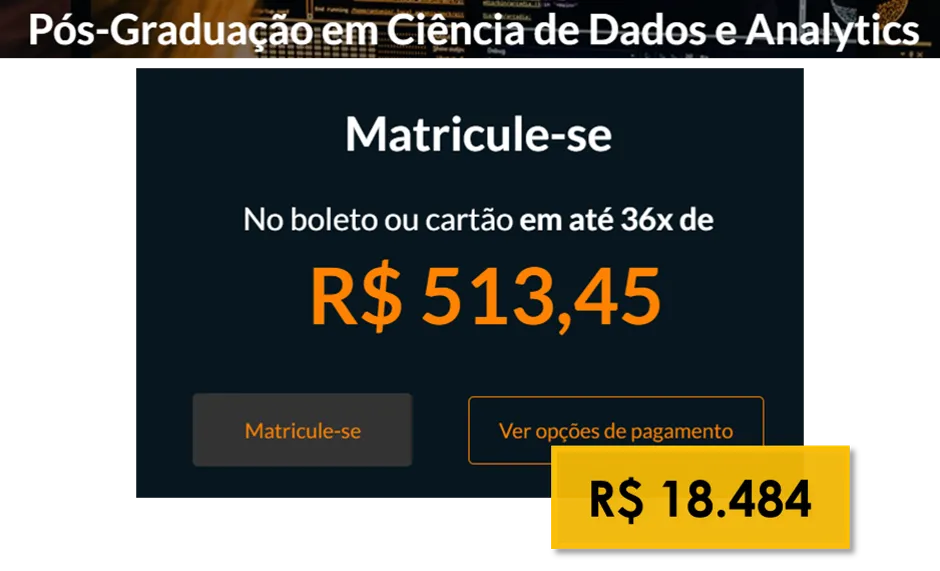
Se você for procurar por formações de Ciência de Dados...

Asset 21
Asset 22
Asset 23

E por mais que seja um investimento alto, confesso pra você que eu acho justo esse valor, por todo o potencial e oportunidades que dominar Ciência de Dados pode te abrir.

E eu te adianto: A formação Ciência de Dados Impressionador não vai ser 17, 18 mil mas também já adianto que não vai ser baratinho.

Só pra você ter uma noção de comparação, se você procurar, também vai encontrar alguns cursos menores, mas que não são formações completas como o Ciência de Dados Impressionador é, e muitas vezes só vão te ensinar uma fração do que você precisa, e mesmo esses cursos menores saem por 4 mil, 5 mil reais.

CursoCD valores

Mas eu quero ajudar as pessoas de forma mais acessível, e cobrar um valor menor do que eu considero um valor justo pra te entregar o melhor Programa de Ciência de Dados do Brasil.

Comece hoje mesmo.
Faça sua inscrição agora.

A oferta do Ciência de Dados Impressionador se encerra em:

00

Dias

:

00

Horas

:

00

Minutos

:

00

Segundos

LogoCienciadeDados1

Valor e formas de pagamento na próxima etapa.

BandeirasPagto

Seu investimento está completamente seguro!
Já que temos dois tipos de Garantia:

Ciencia de Dados Impressionador Ciencia de Dados Impressionador GARANTIA DE 7 DIAS . GARANTIA DE 7 DIAS . GARANTIA DE 7 DIAS . GARANTIA DE 7 DIAS - GARANTIA DE 7 DIAS - GARANTIA DE 7 DIAS -

Garantia Incondicional de 7 Dias

Se por qualquer motivo você não se identificar com o curso ou se arrepender, você pode acionar a garantia incondicional de 7 dias. Ou seja, você pode assistir o curso e se não gostar, é só pedir o seu dinheiro de volta dentro dos primeiros 7 dias.

Ciencia de Dados Impressionador Ciencia de Dados Impressionador GARANTIA DE RESULTADO - GARANTIA DE RESULTADO - GARANTIA DE RESULTADO - GARANTIA DE RESULTADO - GARANTIA DE RESULTADO - GARANTIA DE RESULTADO -

Garantia de Resultado

Se você seguir TODO o método – concluir o curso, fazer os exercícios, criar os projetos, tirar dúvidas no suporte e aplicar tudo o que aprender – e mesmo assim não alcançar resultados (como não conseguir uma promoção, uma efetivação, se destacar na sua empresa ou vender seu projeto) em 6 meses, devolvemos 100% do seu investimento, como prova do nosso compromisso com o seu sucesso!

Isso significa risco zero para você e toda a responsabilidade do nosso lado!

Quais são as formas de pagamento?

Escolha a melhor forma de pagamento para você!

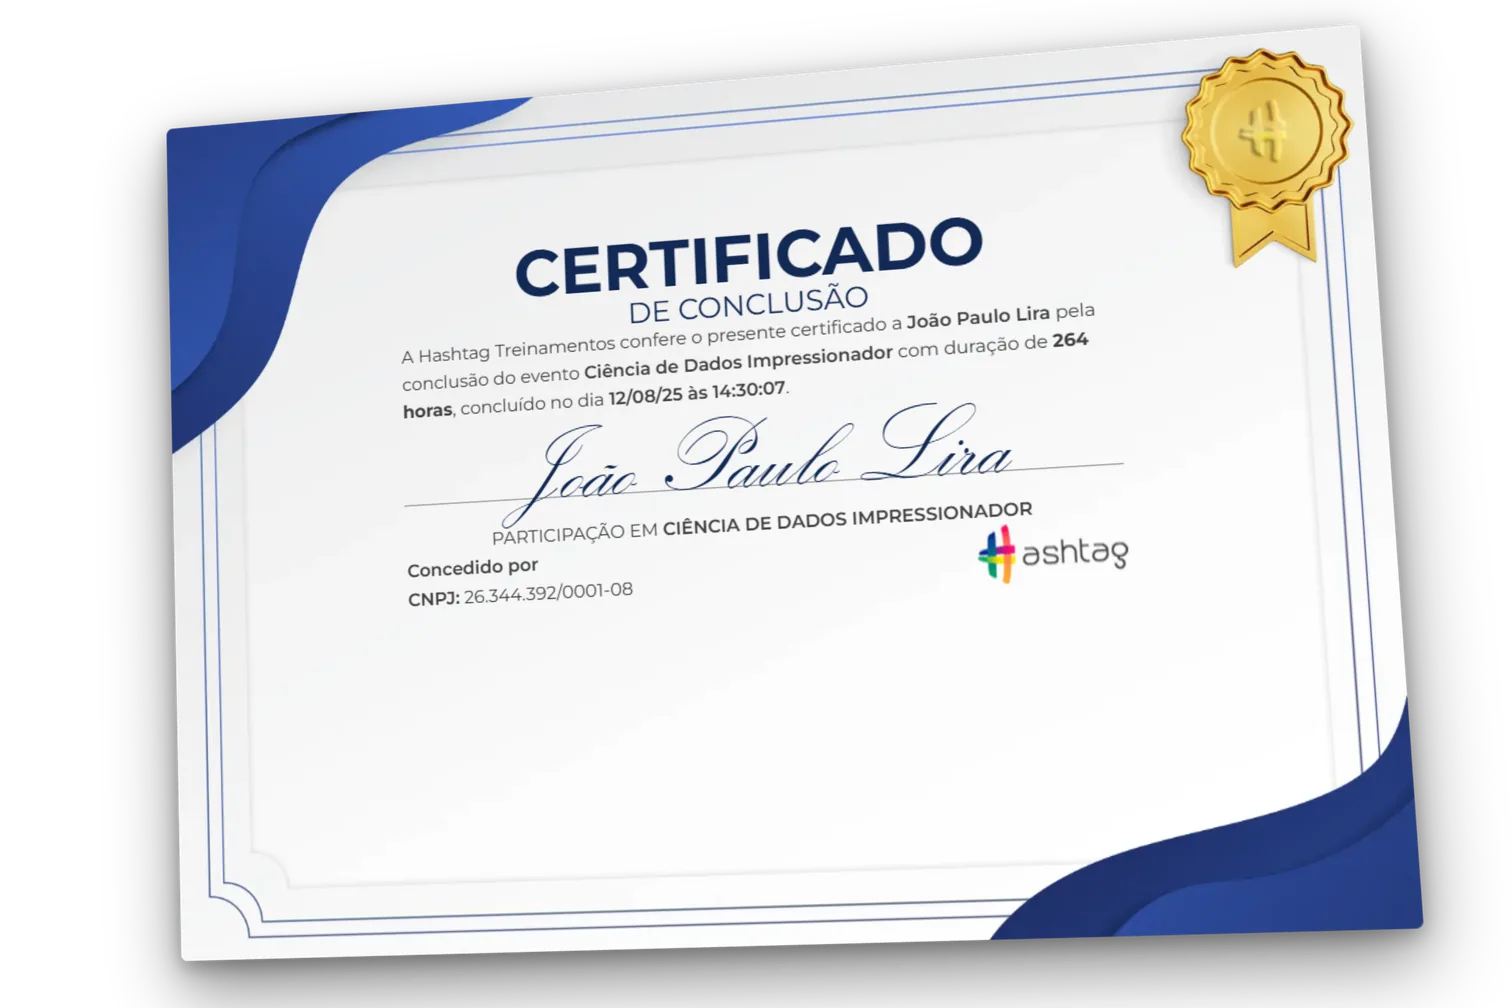
Modelo do certificado de conclusão do Ciência de Dados Impressionador

Certificado Reconhecido em todo o Brasil, por Empresas e Instituições de Ensino

Quem é Hashtag Treinamentos e quem são seus professores?

A Hashtag Treinamentos é a maior empresa da América Latina em treinamentos de Ciência de Dados, Python e Power BI.

Com mais de 210 mil alunos nos cursos completos, mais de 3,3 milhões de inscritos nos canais do YouTube e um foco claro: ajudar você a entrar e se destacar no Mercado de Trabalho.

Lucas, Lira e Francisco, seus professores nessa formação, são especialistas em Ciência de Dados da Hashtag Treinamentos e responsáveis por toda a estruturação dessa formação completa que já ajudou mais de 5 mil pessoas diretamente a se destacarem com Ciência de Dados.

LivroCienciDadosImpr

Como funciona o Livro Digital Ciência de Dados Impressionador?

O Livro Digital Ciência de Dados Impressionador é o material didático do programa online Ciência de Dados Impressionador.

Esse Livro, de autoria do Lucas Leal e do João Paulo Lira, sócio da Hashtag Treinamentos, Registro ISBN 978-65-995844-6-6, possui absolutamente todo o conteúdo passo a passo do básico até o avançado de Ciência de Dados, contando com centenas de páginas com explicações e ilustrações práticas e didáticas.

Você irá receber o Livro Digital Ciência de Dados Impressionador por e-mail, assim que realizar sua inscrição no programa Ciência de Dados Impressionador.

Ciência de Dados

O que é o Curso de Ciência de Dados?

O Curso de Ciência de Dados da Hashtag Treinamentos é uma formação online e completa que ensina Machine Learning, Deep Learning e análise avançada de dados com Python e as principais bibliotecas do mercado.

+260h de conteúdo em vídeo
+1.280 aulas práticas
4,6/5 605 avaliações de alunos

Nível

Do zero ao avançado

Instrutor

Francisco Bustamante

Para quem é

Quem quer atuar com ciência de dados, machine learning e inteligência artificial.

Certificado

Reconhecido em todo o Brasil.

O que você aprende

  • [R] R Básico
  • Introdução ao Deep Learning
  • Introdução ao Tensorflow
  • Primeiras Redes Neurais
  • Introdução à Ciência de Dados
  • Python Básico
  • Introdução ao Aprendizado de Máquinas
  • Seleção de modelos
  • Pandas
  • Numpy
  • Matplotlib e Seaborn
  • Estatística
  • Regressão com modelos lineares
  • Classificação com modelos lineares
  • Árvores de decisão
  • SVM - Máquina de Vetores de Suporte
  • KNN - Vizinhos mais próximos
  • Redução de dimensionalidade
  • Clustering
  • Projeto - Criando uma Apresentação Executiva
  • Projeto - Analisando o engajamento do Instagram
  • Conceitos básicos de SQL para Ciência de Dados
  • Técnicas de storytelling com dados: Utilizando o SQL com dados reais de venda
  • Projeto - Preços de casas
  • API - Consumo e Tratamento de Dados de Fontes Externas
  • Projeto em R
  • Projeto - Segmentação de clientes
  • Projeto - Clusterização - Analista de dados do iFood
  • Projeto MNIST
  • Projeto CIFAR
  • Projeto AutoMPG
  • Projeto IMBD
  • Portfolio
  • Projeto - IBM attrition
  • Projeto - Identificação de fraudes
  • Projeto - Emissão de CO2

Conteúdo desta página atualizado em

O que dizem os alunos do Curso de Ciencia de Dados?

Pedro Henrique
Trabalhava na organização de estoque e não entendia o planejamento por trás das campanhas.
Júlio César
Conseguiu estágio e depois virou analista usando o conteúdo gratuito de Excel e Power BI da Hashtag.
Bruno Felipe
Engenheiro eletricista que queria migrar para a programação, mas não se adaptava a nenhum curso.
Felipe Ribeiro
Entrou em um projeto de previsão de demanda (S&OP) usando Python e Power BI.
Eduardo de Oliveira
Formado em Estatística, usou a formação para concluir sua especialização na área de dados.
Vinicius Valiati
Tem 22 anos e já tinha feito até pós em Data Science quando conheceu a formação da Hashtag.

O que é ciência de dados?

Ciência de dados é a parte que olha para a frente. Enquanto a análise responde "o que aconteceu", aqui a pergunta é "o que vai acontecer, e o que fazer a respeito": qual cliente tende a cancelar, quanto vai vender no mês que vem, qual transação parece fraude. A resposta sai de um modelo treinado em dado histórico, não de uma opinião.

O caminho é sempre o mesmo: entender o problema de negócio, preparar o dado, escolher e treinar o modelo, medir se ele acerta em dado que nunca viu, e colocar para rodar. Python é onde isso acontece — pandas para o dado, scikit-learn para os modelos clássicos, TensorFlow ou PyTorch quando o problema pede rede neural.

Por que aprender ciência de dados?

É uma das áreas com maior distância entre demanda e gente qualificada, e a razão é que ela cobra três coisas ao mesmo tempo: programação, estatística e entendimento do negócio. Quem junta as três é raro, e é isso que sustenta a faixa salarial.

E a porta de entrada não é só a vaga de cientista de dados. Analista, engenheiro de dados, especialista em machine learning e as funções de IA aplicada saem todas do mesmo tronco — aprender isso abre um leque, não uma vaga.

Rodar um modelo ou entender o que ele está dizendo

Tutorial de biblioteca Ciência de Dados Impressionador
Copia o código, o modelo roda, e ninguém sabe se acertou. Mede em dado que o modelo nunca viu — que é a única coisa que separa modelo bom de modelo que decorou.
Começa pela rede neural, porque é o que dá audiência. Começa pelo machine learning clássico, que é o que a empresa mais usa e o que dá a intuição do resto.
Pressupõe que você já programa. Python entra junto com o problema que ele resolve, sem pré-requisito.
Termina no notebook. Vai até o projeto de ponta a ponta: problema de negócio, dado preparado, modelo medido e rodando.

O que você leva no Ciência de Dados Impressionador

Python para dados do zero

Sem pré-requisito de programação: a linguagem entra junto com o problema que ela resolve, não antes dele.

Machine learning com projeto real

Modelos clássicos de ponta a ponta — do dado bruto à medição de erro em dado que o modelo nunca viu.

Deep learning quando o problema pede

Redes neurais aplicadas a imagem e texto, com o critério de quando vale a pena e quando é exagero.

Certificado de conclusão

Ao completar a formação você emite o certificado, reconhecido por empresas e instituições em todo o Brasil.

Suporte para tirar dúvidas

Nossa equipe de especialistas responde às suas dúvidas, tanto do curso quanto do projeto que você está tocando.

Portfólio com projetos reais

Projetos guiados do começo ao fim — de segmentação de clientes a detecção de fraude — e um módulo dedicado a montar o seu portfólio.

Conteúdo programático

O que você aprende no Curso de Ciência de Dados?

São 6 trilhas completas — Python para dados, Estatística, SQL e R, Machine Learning, Deep Learning e Projetos e portfólio — do básico ao avançado, com +260 horas de conteúdo em +1.280 aulas práticas. Você não aprende uma ferramenta isolada: domina todo o ciclo do dado, da coleta à decisão.

Python para dados A linguagem da ciência de dados 214 aulas
  • Introdução à Ciência de Dados
  • Python Básico
  • Pandas
  • Numpy
  • Matplotlib e Seaborn
  • API
Estatística A base científica da análise 124 aulas
  • Estatística
SQL e R Bancos de dados e análise estatística 72 aulas
  • [R] R Básico
  • Conceitos básicos de SQL para Ciência de Dados
  • Técnicas de storytelling com dados
Machine Learning Modelos preditivos do mercado 450 aulas
  • Introdução ao Aprendizado de Máquinas
  • Seleção de modelos
  • Regressão com modelos lineares
  • Classificação com modelos lineares
  • Árvores de decisão
  • SVM
  • KNN
  • Redução de dimensionalidade
  • Clustering
Deep Learning Redes neurais e TensorFlow 50 aulas
  • Introdução ao Deep Learning
  • Introdução ao Tensorflow
  • Primeiras Redes Neurais
Projetos e portfólio Casos reais, do dado à entrega 378 aulas
  • Criando uma Apresentação Executiva
  • Analisando o engajamento do Instagram
  • Preços de casas
  • Projeto em R
  • Segmentação de clientes
  • Clusterização
  • Projeto MNIST
  • Projeto CIFAR
  • Projeto AutoMPG
  • Projeto IMBD
  • Portfolio
  • IBM attrition
  • Identificação de fraudes
  • Emissão de CO2

A grade é atualizada constantemente para acompanhar o que o mercado de dados mais cobra, incluindo o uso de Inteligência Artificial no dia a dia.

Quero a grade completa

Perguntas frequentes

  • Clique em qualquer botão de inscrição desta página. Abre uma janela onde você preenche seus dados e escolhe a forma de pagamento; a matrícula é confirmada na hora e o acesso à formação é liberado em seguida, com todas as aulas já disponíveis.

  • Seu acesso é imediato, assim que o pagamento for aprovado você recebe um e-mail com seus dados de acesso.

    Se o pagamento for em cartão ou no PIX, seu acesso é normalmente liberado em até 15min. Em alguns casos pode ser que demore algumas horas para liberar, então qualquer dúvida, basta entrar em contato com a nossa equipe em lira@hashtagtreinamentos.com.

    Se o pagamento for feito em boleto, normalmente demora de 1 a 2 dias úteis para a liberação, pois esse é o tempo de compensação dos boletos por parte dos bancos.

  • Temos várias formas de pagamento disponíveis. São elas:
    - Cartão de Crédito: à vista ou parcelado em até 12x

    Essa forma permite você dividir o valor do curso em até 12 parcelas, escolhendo exatamente em quantas vezes você vai pagar.

    Basta entrar no link de pagamento padrão (em qualquer botão nessa página) e escolher a opção "Cartão de Crédito"

    - Boleto à vista
    - PIX à vista

    Para acessar a opção do Pix, é só você mudar a opção de “Cartão de Crédito” para “Pix” logo abaixo dos campos de cadastro dos seus dados.

    Atenção: o nome do favorecido que irá aparecer na sua conta não será o da Hashtag, e sim do BTG (Ayden do Brasil). Mas não precisa se preocupar que está certinho!

  • A inscrição é parcelada em até 12x no cartão, e você só é cobrado uma parcela de cada vez.
    O valor aparece na tela de inscrição, antes de qualquer confirmação.

  • Você tem acesso à formação por 2 anos. Pode ver e rever quantas vezes quiser e a plataforma funciona em qualquer dispositivo: celular, tablet, tv ou computador.

  • Sim. Você tem 7 dias de garantia incondicional a partir da compra. Se nesse prazo sentir que o curso não é para você, basta solicitar o reembolso e devolvemos 100% do valor, sem burocracia. Na prática, você conhece o conteúdo sem risco.

    Durante esses 7 primeiros dias você pode testar a plataforma à vontade e, se achar que o investimento não foi proveitoso, pedir o reembolso integral do valor pago pelo e-mail lucas@hashtagtreinamentos.com. Acatamos o pedido sem fazer nenhum tipo de pergunta — a ideia é deixar você sem nenhum risco sobre a decisão que está tomando.

  • Você recebe um certificado de conclusão sim! A formação de Ciência de Dados gera um certificado de 264 horas.

    Assim que você assistir todo o conteúdo da plataforma basta entrar em contato com a gente solicitando o certificado (pode mandar um e-mail para lucas@hashtagtreinamentos.com).

    Vamos checar se realmente todas as aulas foram assistidas e, em seguida, te mandamos por e-mail o certificado de conclusão. Dessa forma, adquirindo uma vaga no Programa você terá, se assistir todo conteúdo, 264 horas complementares.

    Esse certificado pode ser impresso por você e usado juntamente à instituição de ensino superior para contabilizar horas de atividades complementares. Além disso, se necessário, você também pode usar o certificado para comprovar para empresas de mercado que fez os nossos cursos ou formações.

  • As inscrições não têm uma data para início e fim.

    MAS, nos damos o direito de alterar qualquer condição dessa oferta a qualquer momento, sem aviso prévio, inclusive aumentos de preço.

    Isso significa que se você entrar aqui amanhã vai estar mais caro ou sem algum bônus que estamos oferecendo? Não necessariamente.

    Mas isso significa que é uma possibilidade, sendo 100% transparente. Digo isso porque já fizemos alterações em outros cursos da Hashtag sem aviso prévio e muitas pessoas se arrependeram de não terem garantido sua vaga antes, quando as condições eram melhores.

  • Essa é uma preocupação muito válida! O que posso te dizer é que somos uma empresa que preza muito pela satisfação dos nossos clientes. Você pode conferir isso procurando por "Hashtag Treinamentos" no Google, YouTube, Instagram e Facebook. Vai ver que temos mais de 1,8 milhão de seguidores no Instagram, mais de 3,3 milhões de inscritos no YouTube e nossas avaliações são excelentes em sites de reclamação. Pode ter certeza que somos uma empresa séria e confiável! Pode checar nosso site também: www.hashtagtreinamentos.com

  • Emitimos nota fiscal sim! Em 7 dias você receberá automaticamente no seu e-mail a nota fiscal referente à compra da formação. Este prazo está relacionado com o nosso período de garantia.

    Caso você queira receber a nota fiscal antes dos 7 dias, basta enviar um e-mail para lucas@hashtagtreinamentos.com que emitimos para você!

  • Emitimos nota fiscal sim! Após a compra da formação conseguimos alterar os dados da nota (Razão Social, CNPJ, etc) para que você possa solicitar o reembolso na sua empresa.

    Basta enviar um e-mail para lucas@hashtagtreinamentos.com solicitando a alteração dos dados que atualizamos para você! E pode ficar tranquilo pois o certificado em si será emitido com os seus dados pessoais, apenas a nota sairá com os dados da empresa.

  • Pedimos para que você entre em contato com comercial@hashtagtreinamentos.com informando os seguintes dados sobre a empresa:

    - Razão Social
    - CNPJ
    - CEP

    Além disso, precisaremos saber também se o pagamento será feito via transferência ou boleto bancário.

    Enviando essas informações para o e-mail acima, até amanhã enviamos a Nota Fiscal para você. E pode ficar tranquilo que todos os bônus serão mantidos para o seu caso.

  • Aqui na página, no canto inferior à direita tem um chat ao vivo (com pessoas reais, não é um robô) para tirarmos suas dúvidas.

    Pode colocar sua dúvida lá que alguém da nossa equipe vem te atender.

    Se no momento que você estiver vendo a página o chat estiver offline, você pode enviar um e-mail para alon@hashtagtreinamentos.com que vamos te responder e te ajudar.

  • O Ciência de Dados Impressionador é composto por (1) vídeo aulas da Plataforma Online Ciência de Dados Impressionador e (2) pelo Livro Digital Completo Ciência de Dados Impressionador. A Plataforma Online possui vídeo aulas passo-a-passo e instrutivas, com orientações completas sobre o uso de todas as ferramentas importantes para o mercado de trabalho. O Livro Digital Completo Ciência de Dados Impressionador é um material independente das vídeos aulas da Plataforma, produzido pela Hashtag Treinamentos, e com todas as informações necessárias para você aprender Ciência de Dados do absoluto zero. Você consegue aprender tudo, do zero, apenas lendo o conteúdo do Livro Digital. No entanto, é aconselhado ao aluno que faça um estudo mesclando as vídeo aulas e o conteúdo do Livro Digital. Ambos são enviados ao aluno, pelo e-mail de cadastro, assim que o pagamento é confirmado. O Livro Digital não pode ser compartilhado, em nenhuma hipótese, com terceiros.

  • A formação Ciência de Dados Impressionador é composta por 1.288 aulas, do básico ao avançado, que totalizam 264 horas de puro conteúdo de Ciência de Dados e te mostram tudo o que você precisa saber para virar uma referência por causa dos seus conhecimentos em Ciência de Dados.

    Todas as semanas estamos gravando novos conteúdos e adicionando na plataforma.

    Você tem acesso por 2 anos, então você poderá acessar à vontade todas as aulas, assistir e reassistir quantas vezes quiser, além de tirar todas as dúvidas com a nossa equipe de especialistas.

  • Isso varia de pessoa para pessoa, porque a formação é 100% liberada assim que você se inscreve. Então você pode seguir no seu próprio ritmo, já que tem acesso por 2 anos. Pode ver e rever as aulas quantas vezes quiser.

    Normalmente nossos alunos demoram cerca de 3-4 meses para conseguirem ter os resultados que procuram com a formação.

    Alguns alunos demoram menos, mas alguns alunos demoram mais também, entre 6 e 8 meses, depende da disponibilidade de cada um.

    O que importa é, cada um pode seguir o seu ritmo, de forma que a formação é adaptada para você.

    Recomendamos, para evoluir em um ritmo bom, que você tente criar uma rotina semanal para a formação. Cerca de 1h-2h por semana já é o suficiente para progredir.

    Quanto mais tempo tiver para dedicar, mais rápido vai progredir.

  • As aulas são gravadas e disponibilizadas imediatamente após a confirmação da sua inscrição. Não fazemos liberação por módulos, o curso todo é liberado para você desde o 1º dia.

    Em alguns momentos ao longo dos meses, fazemos aulas extras ao vivo, para ajudar vocês em situações que vocês estejam querendo se desenvolver mais. Essas aulas são combinadas e avisadas com antecedência sempre por e-mail e nos grupos de whatsapp, bem como o tema de cada aula.

    Todas essas aulas ao vivo são gravadas e disponibilizadas em um módulo dentro do Power BI Impressionador, para quem não conseguiu participar ao vivo poder aprender também.

  • O Programa Ciência de Dados Impressionador é 100% online. Não tem nada que seja presencial. Todas as aulas estão gravadas nas nossas plataformas online e você pode assistir e reassistir quantas vezes quiser e de qualquer lugar do mundo, desde que tenha uma conexão boa com a internet.

  • Temos um canal exclusivo para dúvidas! Esse canal é a área de dúvidas da plataforma Ciência de Dados Impressionador. Cada aula tem um espaço para você deixar suas dúvidas e/ou deixar seus comentários. Temos uma equipe de experts especialmente treinada para responder qualquer dúvida que você tiver em até 24 horas na plataforma, de segunda a sexta.

    Esse suporte serve tanto para o conteúdo das aulas quanto para exercícios e para códigos que você esteja tentando fazer por conta própria.

    Repare apenas que essa não é uma mentoria individual nem uma consultoria: as dúvidas são postadas na plataforma e respondidas por lá. Não construímos um código por você nem tocamos um projeto com você — tiramos dúvidas sobre o que você não entendeu e ajudamos pontualmente onde for necessário.

  • Sim, temos grupos de whatsapp com todos os alunos, mas não é um grupo obrigatório.

    Assim que você finalizar sua inscrição, enviaremos um e-mail para você com um link para entrar no grupo do whatsapp.

    Caso não queria fazer parte do grupo, não é obrigatória, e todas as comunicações também são enviadas por e-mail.

    Os grupos servem para ser um canal mais direto de comunicação com os alunos e para os alunos trocarem experiência entre si.

  • São 13 projetos com dados reais, aplicando o que você aprendeu de ponta a ponta: segmentação e clusterização de clientes (com base de delivery), identificação de fraudes, previsão de preços de imóveis, rotatividade de funcionários (RH), emissão de CO2, análise de engajamento no Instagram, classificação de imagens com redes neurais (MNIST e CIFAR) e análise de sentimento em avaliações de filmes, entre outros. Há ainda um módulo dedicado ao portfólio: como organizar e apresentar esses projetos — que é o que o recrutador olha quando você não tem experiência prévia na área.

  • Existem 2 públicos a quem esse programa se destina: 1) Quem quer entrar nas carreiras mais valorizadas pelo Mercado de Trabalho; 2) Quem quer saber qual é o próximo passo para se destacar na sua empresa ou em um processo seletivo.

  • Não, apenas um computador com acesso à internet mesmo. Todas as ferramentas que vamos usar na formação são gratuitas e vamos mostrar como instalar e como usar de forma bem passo a passo. Além disso, vamos mostrar todo o conteúdo do zero, iniciando com conceitos bem simples e avançando aos poucos até chegar em fórmulas e ferramentas mais complexas, 100% passo a passo e com diversos exercícios de fixação a cada etapa.

  • Não. A formação começa pelo Python do zero — variáveis, estruturas, bibliotecas — antes de qualquer modelo de machine learning. Só o módulo de Python Básico tem 85 aulas, e ainda vêm Pandas, NumPy e visualização de dados. Quem já programa avança mais rápido; quem nunca programou tem o caminho completo desde a primeira linha de código.

  • Uma base de matemática e estatística ajuda bastante, porque é o que separa apenas aplicar um algoritmo de entender por que ele funciona. Mas você não precisa chegar sabendo tudo: o curso constrói esses fundamentos junto com a prática, do zero ao avançado.

  • Com certeza! A formação foi criado de forma 100% passo a passo e com muitos exercícios para você treinar cada etapa. Então mesmo quem já teve uma experiência difícil com qualquer tipo de programa no computador vai conseguir seguir o ritmo da formação numa boa.

    Além disso, vamos dar suporte diariamente a todas as dúvidas, justamente para que ninguém fique travado com qualquer dificuldade.

  • O cientista de dados coleta e analisa dados de várias fontes e constrói modelos preditivos (machine learning) para apoiar decisões da empresa. Combina estatística, matemática, programação (geralmente Python) e Big Data para transformar dados em previsões e insights acionáveis.

  • O analista de dados resolve problemas de negócio com dados estruturados e relatórios (foco descritivo). O cientista de dados vai além: cria modelos preditivos e de machine learning, exigindo mais estatística, matemática e programação. Na prática, o cientista domina o que o analista faz, e mais.

  • A formação tem 264 horas de conteúdo. Estudando 1 hora por dia, você percorre o programa completo em cerca de 9 meses; com 2 horas por dia, em cerca de 4 meses. Como as aulas são gravadas, o ritmo é seu: dá para acelerar nas partes que você já domina e voltar quantas vezes quiser nas que exigem mais prática. Na prática, os primeiros resultados aparecem antes do fim: já nos módulos iniciais de Python e análise de dados você consegue aplicar o que aprendeu no trabalho.

  • A graduação é um caminho, mas não é o único: a maior parte das vagas de cientista de dados cobra domínio de ferramentas e projetos entregues, não um diploma específico. Muitos profissionais da área vêm de engenharia, economia, estatística, administração ou TI e se especializaram depois. A diferença de uma formação como esta é o foco: em vez de 4 anos de grade ampla, você vai direto ao que o mercado usa — Python, SQL, estatística aplicada, machine learning — e sai com projetos reais no portfólio. O certificado é reconhecido em todo o Brasil e pode ser usado como horas complementares em muitas instituições.

  • Ciência de Dados se aplica a qualquer área do mercado por se tratar da área na qual você analisa, trata e interpreta os dados das empresas, independente do segmento de atuação.

    Isso significa que aprender Ciência de Dados vai abrir para você um mundo de possibilidades e vai te tornar muito mais requisitado no mercado de trabalho.

    Na formação mostramos uma diversidade de exemplos e aplicações mais usadas no mercado, então ela é 100% prática e te dá o background necessário para criar os seus próprios projetos com tranquilidade, inclusive os que vão te ajudar nas suas tarefas específicas.

  • Sim! Se você quiser conhecer todos os Programas Completos da Hashtag Treinamentos, basta clicar aqui! Além do curso de Ciência de Dados Completo, também temos treinamentos completos de Excel, Python, SQL e muitos outros. Não deixe de conferir!

Fazer minha inscrição