Como Tratar Variáveis de Texto de um Dataset Real?
Hoje eu quero te mostrar como tratar variáveis de texto de um dataset real! Aprenda 5 maneiras diferentes de fazer este tratamento.
Caso prefira esse conteúdo no formato de vídeo-aula, assista ao vídeo abaixo ou acesse o nosso canal do YouTube!
Para receber por e-mail o(s) arquivo(s) utilizados na aula, preencha:
Fala impressionadores! Saber Tratar variáveis de texto é importante, pois muitas vezes temos variáveis de texto ao invés de apenas números, e os algoritmos de aprendizado de máquina precisam dessas informações em forma de número.
Como esses algoritmos não consegue utilizar variáveis com valores categóricos precisamos ajustá-las para usar um modelo de aprendizado de máquina!
Além disso, ainda vou falar sobre o apply em Python, sobre lambda function, OneHotEncoder e OrdinalEncoder!
E aí, quer ver como eliminar uma coluna no dataset, como verificar informações da base de dados, como eliminar colunas desnecessárias e muito mais?
Para começar vamos utilizar uma base de Previsão de Preço de Voo do Kaggle
Nesta base vamos ter diversas informações sobre os voos, se notarmos a maioria das informações são categóricas, em formato de texto!

Se tentarmos baixar essas informações para um modelo da forma que está, vamos ter um erro!
Então vamos fazer um passo a passo para corrigir essas informações antes de passar para o nosso modelo.
O primeiro passo será importar o Pandas, depois vamos dar um nome a nossa base (dados.csv) e visualizar as 3 primeiras linhas:

Index_col=[0] -> Se quando você importar a base de dados vier uma coluna enumerando as linhas, utilize o index como na imagem acima para excluir esta coluna que é desnecessária.
Observe que as colunas estão em inglês, caso seja mais fácil podemos traduzi-las antes de dar continuidade:

Agora, uma das primeiras coisas que podemos fazer é utilizar o “.info” para obter informações da base:

Temos muitas colunas de texto, podemos começar eliminando colunas desnecessárias:
Quais são as colunas desnecessárias?
São informações que não agregam valor nenhum a nossa análise, por exemplo, estamos analisando o preço de voo, assim, ter uma coluna com o nome de cada voo vai nos ajudar? Esta informação é relevante?
Colunas com valores que se distinguem muito um do outro também podem ser retirados, para isso nós vamos verificar a cardinalidade:
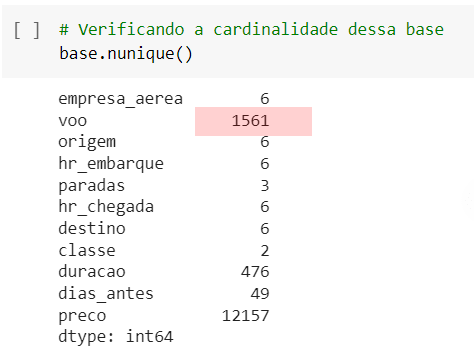
Aqui podemos ver quantos tipos de informação temos por colunas, na Classe temos 2 tipos de informações, por exemplo.
Já no voo temos 1561 tipos de informação. Se essa quantidade enorme não for relevante para a nossa análise, vale a pena excluir ao invés de ter que tratar esse volume de dados.

Verificando essa coluna “voo” percebemos que esta informação é irrelevante, portanto, vamos eliminar a coluna como na imagem acima.
Obs. Nem sempre vamos eliminar colunas com alta cardinalidade, a informação deve ser averiguada antes!
Apply e lambda function
O segundo modo de tratar nossa base é utilizando o apply em Python e o lambda function!
O apply nós vamos utilizar para aplicar alguma função e o lambda function é uma função que vamos escrever na própria linha de forma direta sem precisar gerar complexidade no código.
 Ciência de Dados Impressionador
Se você quiser sair do zero até o nível avançado e aprender absolutamente tudo o que você precisa para usar Ciência de Dados para se destacar no Mercado de Trabalho e poder entrar nas carreiras mais promissoras e desejadas nas empresas, esse curso é pra você.
Começar agora


Vamos mostrar como fazer analisando a coluna Classe

Como a classe é só econômica ou executiva, podemos criar uma coluna com o valor 1, caso seja econômica e 0 no caso de ser executiva.

Observe que agora temos uma coluna numérica “econômica” e essa coluna pode ser usada em um modelo sem problemas.
Agora uma terceira opção de tratarmos os nossos dados:
Ao invés de criar a lambda function, podemos criar uma função separada, neste caso definimos a função para usá-la depois com o Apply.
Como exemplo vamos usar a coluna “Paradas”, vamos visualizar a coluna:

Nesta coluna os valores são 0, 1 ou (2 ou +)
Vamos então criar uma função para tratar esses valores, transformando os textos em números.
Feito isso vamos criar uma coluna e aplicar a nossa função

Pronto, conseguimos tratar e visualizar os dados!
Observe que a coluna nr_paradas tem a mesma informação da coluna de paradas, porém com os resultados numéricos.
Utilizando o OneHotEncoder!
Vamos utilizar o OneHotEncoder quando Não Existe uma relação de ordem entre os valores
Por exemplo, não existe uma relação de ordem entre as empresas aéreas (não podemos dizer que a SpiceJet vem antes da AirAsia ou o contrário)
Vamos transformar os rótulos de dados (os valores que existem nessa coluna empresa_aerea) em novas colunas seguindo os passos abaixo:
Sendo uma coluna com apenas 4 linhas:

O primeiro passo é pegar cada um dos valores dessa coluna (sem repetição) e transformar em uma nova coluna
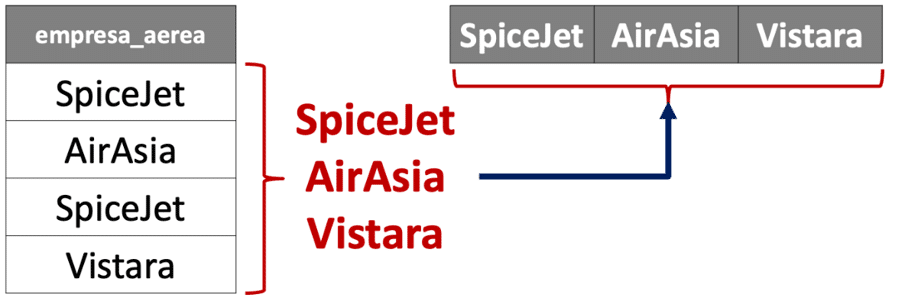
Em seguida, para cada uma das linhas vamos atribuir o valor 1 se o valor da linha for igual ao nome da coluna.
Por exemplo, para a primeira linha o valor da coluna “passagem_aerea” é “SpiceJet”, então para a coluna SpiceJet nós vamos atribuir o valor 1, seguimos esse mesmo raciocínio para todas as colunas.
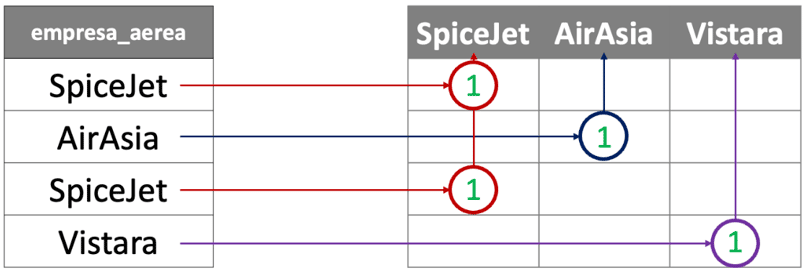
Por fim todas as linhas que não estiverem com o valor 1 receberão o valor 0.

Agora que já entendemos a dinâmica vamos começar a analisar pela coluna empresa_aerea

Podemos transformar esses valores (os rótulos de dados) em colunas.
Para isso vamos importar da nossa documentação OneHotEncoder.

Também podemos transformar isso em um dataframe do Pandas

Como selecionar o nome das colunas pela documentação?

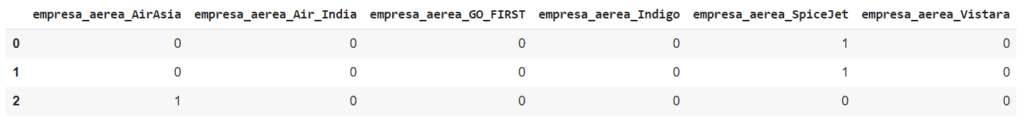


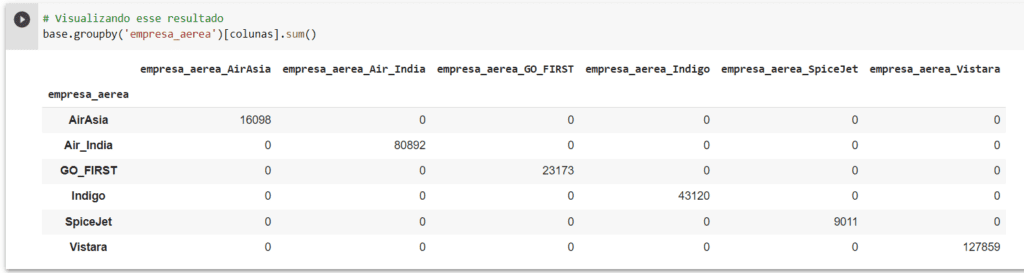
Podemos somar os valores:
Poderíamos ter utilizado o OneHotEncoder inclusive com a coluna classe, observe:

Também podemos voltar no OneHotEncoder e definir o parâmetro drop como if_binary
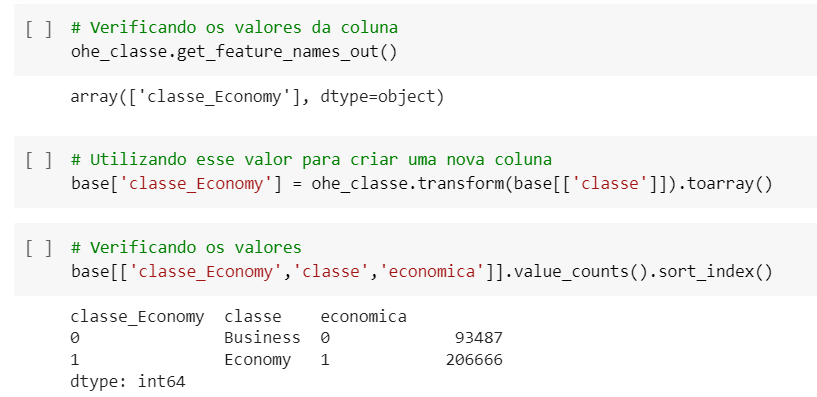
Observe que conseguimos encontrar os mesmos valores de diferentes formas, cabe a você definir qual dos processos é melhor para seu código e utilizar a biblioteca.
Eu recomento o OneHotEncoder porque ele tem mais recursos, inclusive se aparecer um valor novo depois que o modelo estiver pronto, existe na biblioteca um parâmetro de como lidar com valores desconhecidos para tratar mais facilmente essa situação.
Podemos selecionar o máximo de categorias, limitar as categorias, é realmente bem completo!
Por fim vamos falar sobre o OrdinalEncoder
Vamos utilizar o OrdinalEncoder quando de fato EXISTE uma relação de ordem entre os valores
Por exemplo, existe uma ordem entre os horários de partida e de chegada.
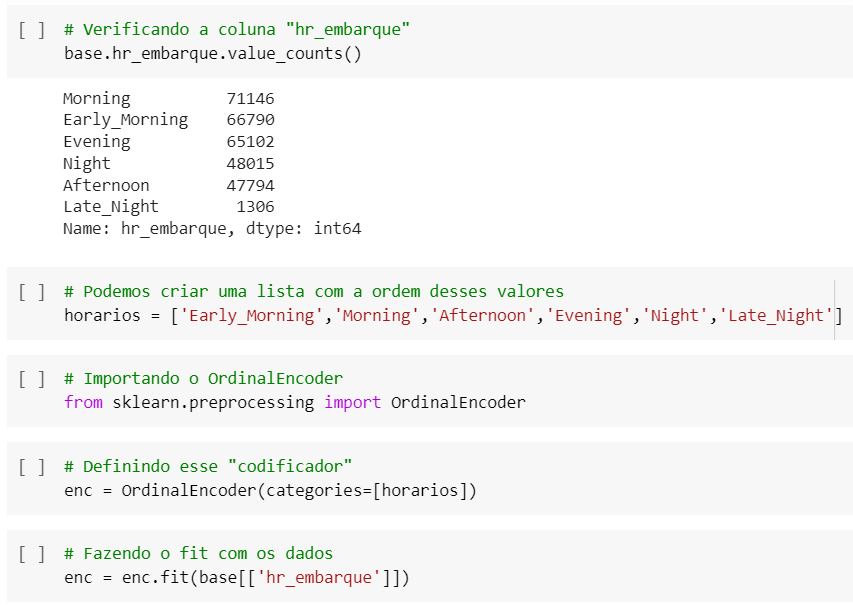
Poderíamos ter utilizado o OrdinalEncoder inclusive com a coluna “paradas”

Então aqui da mesma maneira que fizemos antes, criando uma função, agora nós conseguimos o mesmo resultado com o OrdinalEncoder.
Agora você já tem as ferramentas para tratar as variáveis de texto dentro do seu código!
Eu sugiro que você realmente navegue por essas documentações para obter o melhor da ferramenta, tem muita coisa legal que pode ser feita!
Conclusão – Como Tratar Variáveis de Texto
Nesta aula trouxe 5 formas de fazer o tratamento de variáveis categóricas!
Existem muitas formas de fazer este tratamento na internet, mas, trouxe aqui as bibliotecas e modos que acredito serem mais interessantes.
Novamente agora que já vimos que é possível chegar em resultados iguais com diferentes recursos e que cada um deles tem seu diferencial cabe a você explorar as bibliotecas e escolher qual faz mais sentido para o seu projeto.
Eu fico por aqui! Espero que tenham gostado das dicas! Até mais,
Hashtag Treinamentos
Para acessar outras publicações de Ciência de Dados, clique aqui!